2026 LLM 推理服务引擎深度对比:vLLM · SGLang · TGI · TensorRT-LLM
本地部署 LLM 推理服务是 2026 年最务实的降本方向之一。Cloud API 按 token 计费,月跑量上来后账单很快吃掉预算;而自建推理服务的边际成本几乎可以忽略。但引擎一多,选型就成了第一道坎。
本文聚焦 2026 年 8 月主流四款开源推理引擎的技术内核、性能表现、部署坑位,给出可直接执行的选型建议与命令。内容全部基于官方仓库、社区 benchmark、生产部署经验。
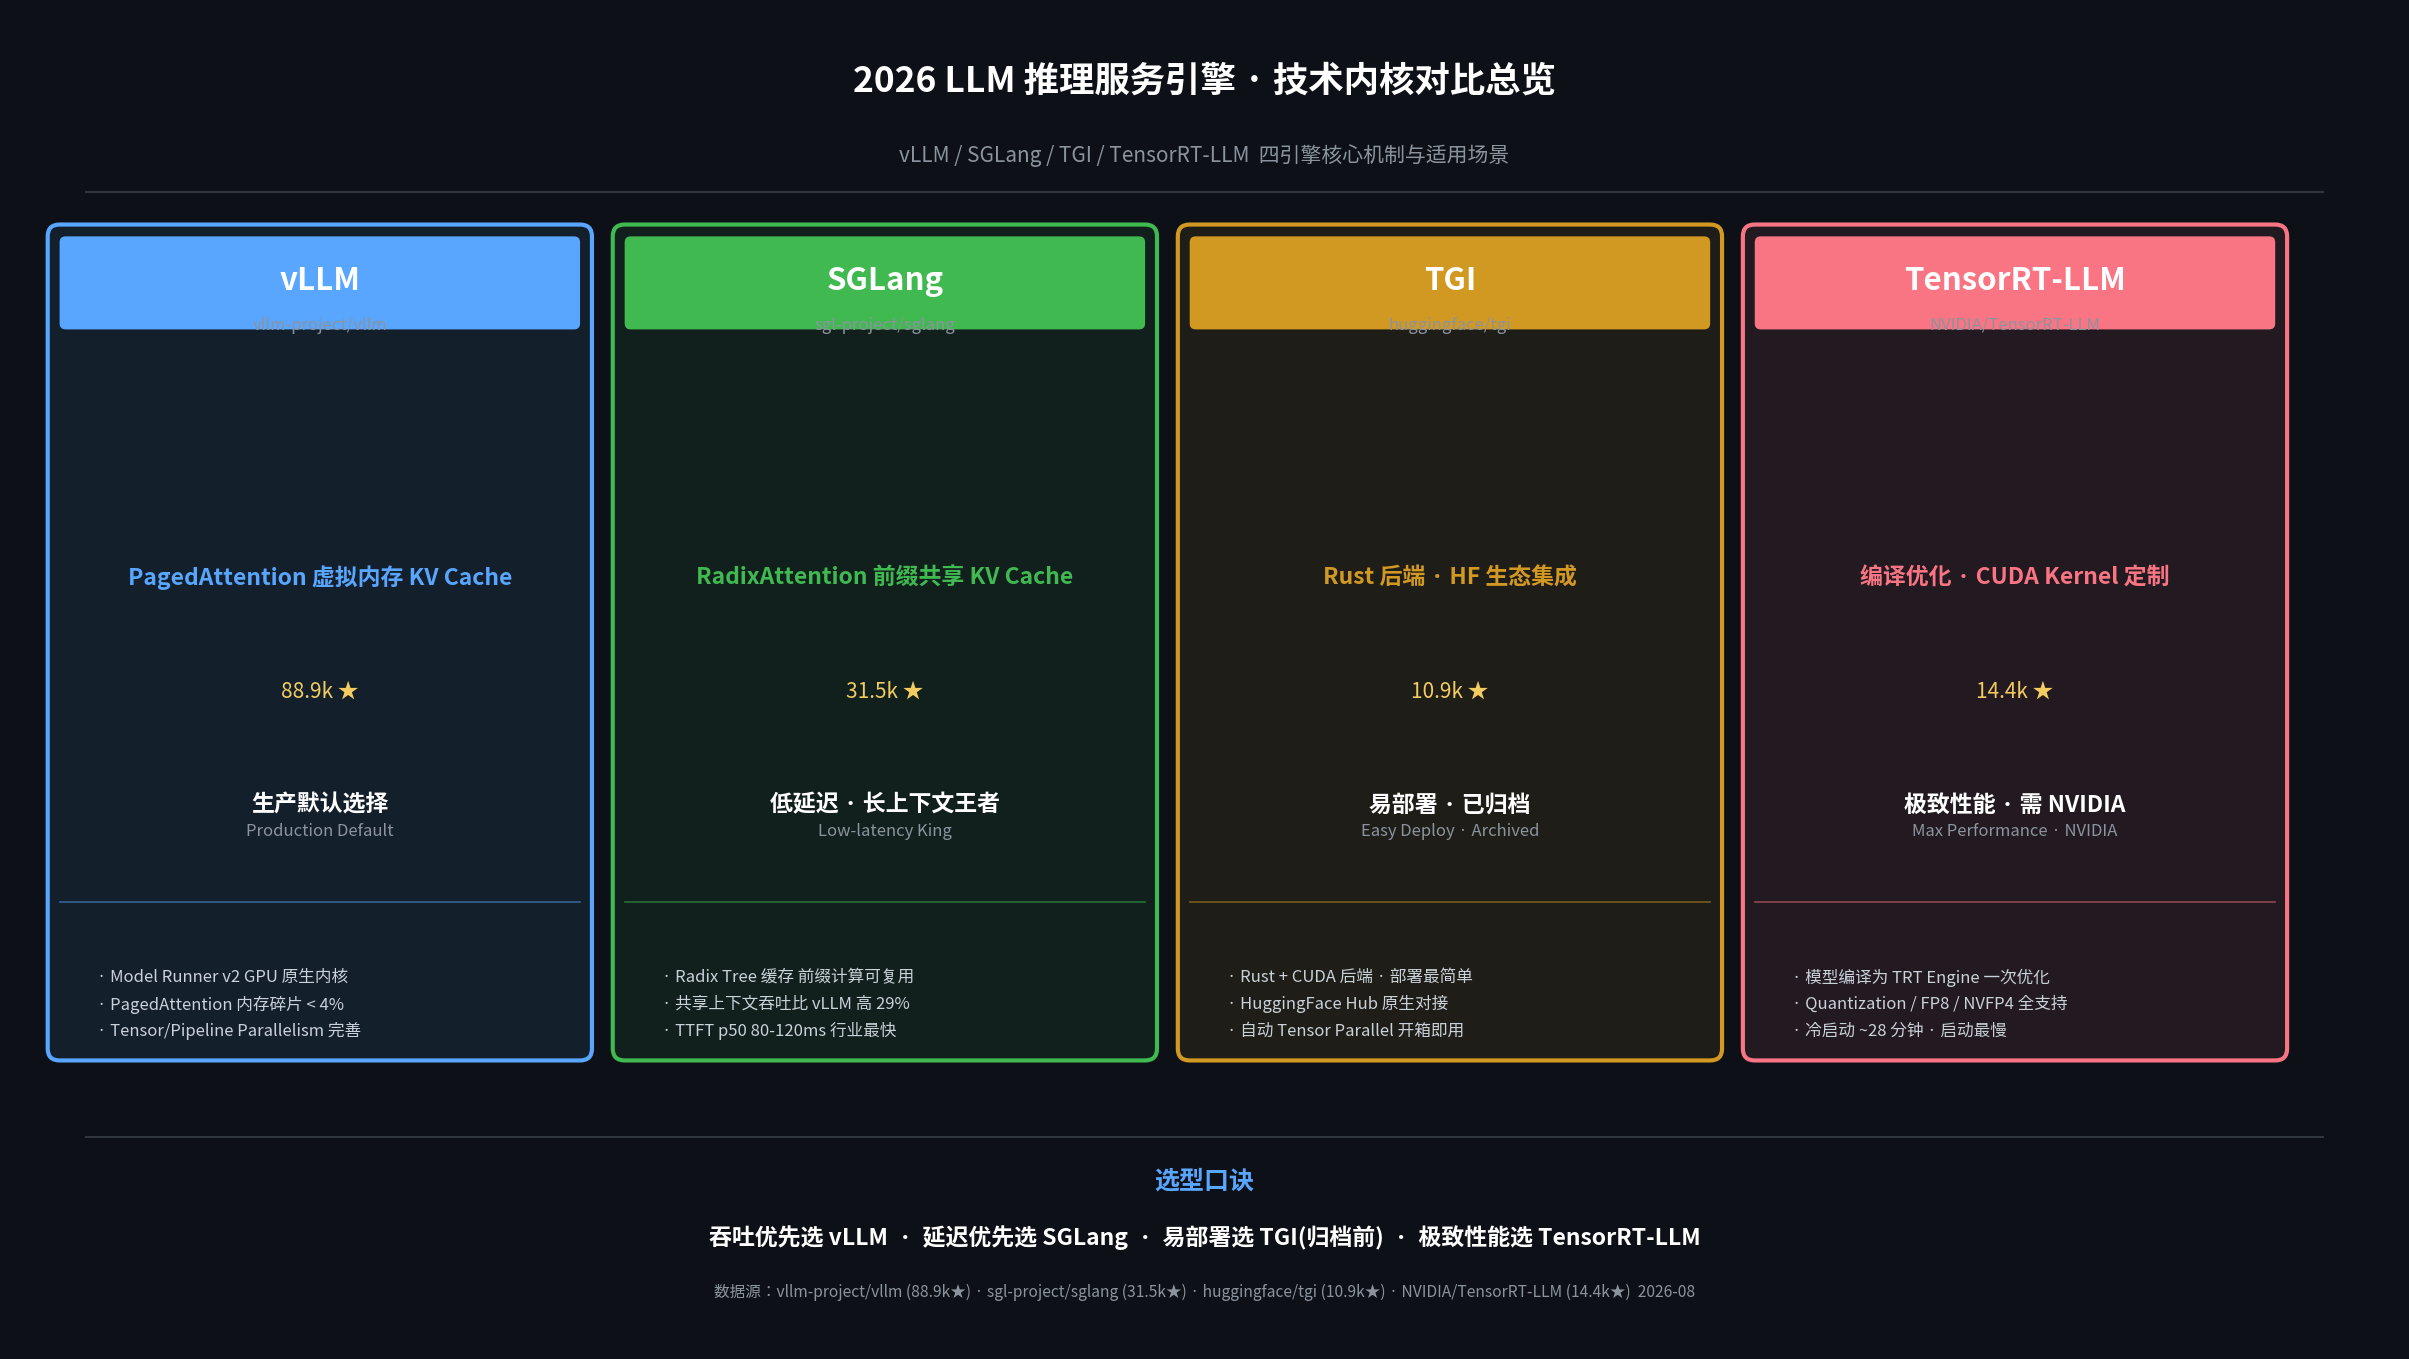
一、四大引擎全景
| 引擎 | 主导方 | GitHub ⭐ | 内核机制 | 一句话定位 |
|---|---|---|---|---|
| vLLM | 伯克利 · vllm-project | 88.9k | PagedAttention 虚拟内存 | 生产默认选择,生态最活跃 |
| SGLang | LMSYS · sgl-project | 31.5k | RadixAttention 前缀共享 | 低延迟 · 长上下文王者 |
| TGI | HuggingFace(已归档) | 10.9k | Rust 后端 · HF Hub 集成 | 易部署 · 2026-03 已归档 |
| TensorRT-LLM | NVIDIA | 14.4k | 编译优化 · CUDA Kernel | 极致性能 · 需 NVIDIA 硬件 |
四个引擎在 2026 年 8 月的社区数据:vLLM 以 88.9k ⭐ 遥遥领先(来源:vllm-project/vllm),已成为 de facto 标准;SGLang 31.5k ⭐(sgl-project/sglang),主打低延迟场景且在多轮对话/RAG 任务中实测比 vLLM 吞吐高 29%;TensorRT-LLM 14.4k ⭐(NVIDIA/TensorRT-LLM),Q3 2026 路线图重点在 KVCache V2、Qwen-Image 与视频稀疏注意力;TGI 10.9k ⭐(huggingface/text-generation-inference),已于 2026 年 3 月正式归档,HF 官方转向 llama-cpp-rs。
二、技术内核对比
2.1 vLLM:PagedAttention 虚拟内存模型
vLLM 的核心创新是 PagedAttention(来源:vllm-project/vllm)—— 把 KV Cache 像操作系统虚拟内存一样分页管理,采用固定大小的 page 而非连续分配。传统实现 KV Cache 内存碎片率 60-80%,vLLM 压缩到 4% 以下。直接收益是同样一块 GPU 上可承载 2-4 倍的并发。
2026 年关键升级是 Model Runner v2:把调度关键路径从 CPU 搬到 GPU 原生 Triton 内核,消除了 CPU 侧瓶颈,吞吐进一步抬升。
生产配置:
1 | vllm serve meta-llama/Llama-3.1-8B-Instruct \ |
适用场景:通用生产推理、高并发 API 服务、对模型覆盖度要求高的团队。
2.2 SGLang:RadixAttention 前缀共享
SGLang 的核心是 RadixAttention(来源:sgl-project/sglang)—— 把 KV Cache 组织成一棵 Radix Tree,当多个请求共享相同前缀(同一 system prompt、相同上下文)时,直接复用已计算过的 KV Cache,不再重复计算。
在多轮对话、Agent 循环、RAG 场景下,这种共享能显著减少计算量。Spheron 的 H100 benchmark 显示:**相同硬件下 SGLang 吞吐比 vLLM 高 29%**(16,200 vs 12,500 tokens/s);TTFT p50 可做到 80-120ms,比 vLLM 快 30-40%。
SGLang 还提供 XGrammar 后端,原生支持 JSON/JSON Schema 结构化输出,绕过早期引擎逐 token 校验的性能损耗,Agent 应用非常友好。
生产配置:
1 | python3 -m sglang.launch_server \ |
适用场景:多轮对话、Agent 编排、RAG、低延迟交互式应用。
2.3 TGI:Rust 后端的易部署王者(已归档)
TGI(Text Generation Inference)是 HuggingFace 官方的部署工具,最大卖点是开箱即用——对接 HF Hub 原生、自动检测 Tensor Parallel、配置项少。
但需关注:2026 年 3 月,TGI 仓库已正式归档(来源:huggingface/text-generation-inference,GitHub 显示 archive 标记),HF 官方已将投入转向 llama-cpp-rs。IBM 维护的 fork(github.com/IBM/text-generation-inference)仍在活跃。
历史项目可用:如果你已有 TGI 部署且模型较老,继续跑没大问题;新项目建议直接上 vLLM 或 llama-cpp-rs。
2.4 TensorRT-LLM:NVIDIA 生态下的性能天花板
TensorRT-LLM(来源:NVIDIA/TensorRT-LLM)的路线和其他三家完全不同——不追求易用性,追求单次推理的绝对性能。它把模型编译为 TRT Engine,在编译阶段完成算子融合、图优化、量化。
- 吞吐:H100 上 50 并发 ~2,100 tokens/s(Spheron benchmark)
- 冷启动:约 28 分钟,远高于其他引擎的几十秒
- 量化支持:FP8 / NVFP4 / INT4 全覆盖
- Q3 2026 路线图:KVCache V2、Qwen-Image 支持、视频稀疏注意力
生产配置:
1 | # 编译引擎 |
适用场景:固定模型、单 GPU 资源紧张、需要极致吞吐的企业级部署。代价是:需 NVIDIA GPU、1-2 周调优周期、硬件锁定。
三、性能基准对比
综合多源 benchmark(Spheron 2026-03、Deploybase 2026 汇总):
| 指标 | vLLM | SGLang | TGI | TensorRT-LLM |
|---|---|---|---|---|
| 吞吐 (50 req) | 1,850 tok/s | 1,920 tok/s | 2,500 tok/s* | 2,100 tok/s |
| TTFT p50 | 120 ms | 80 ms | 250 ms | 105 ms |
| 冷启动 | ~62 秒 | ~58 秒 | ~50 秒 | ~28 分钟 |
| 共享前缀增益 | 中 | 高 (+29%) | 低 | 中 |
| 内存碎片率 | < 4% | 类似 | 略高 | 类似 |
*注:TGI benchmark 数据来自归档前版本,新项目不推荐参考。
关键洞察:
- 独立请求场景(不同用户、不同 prompt):vLLM 与 SGLang 差距在 ±5% 以内,几乎持平。
- 共享前缀场景(多轮对话、Agent、RAG):SGLang 因 RadixAttention 自动缓存前缀计算,**比 vLLM 快 29%**,是明显的赢家。
- 极致吞吐单点:TensorRT-LLM 仍是最优解,但只有当你愿意接受编译时间和调优成本时才值。
- TTFT 敏感:SGLang 的 80ms p50 在实时对话场景中体感差异明显。
四、选型决策树
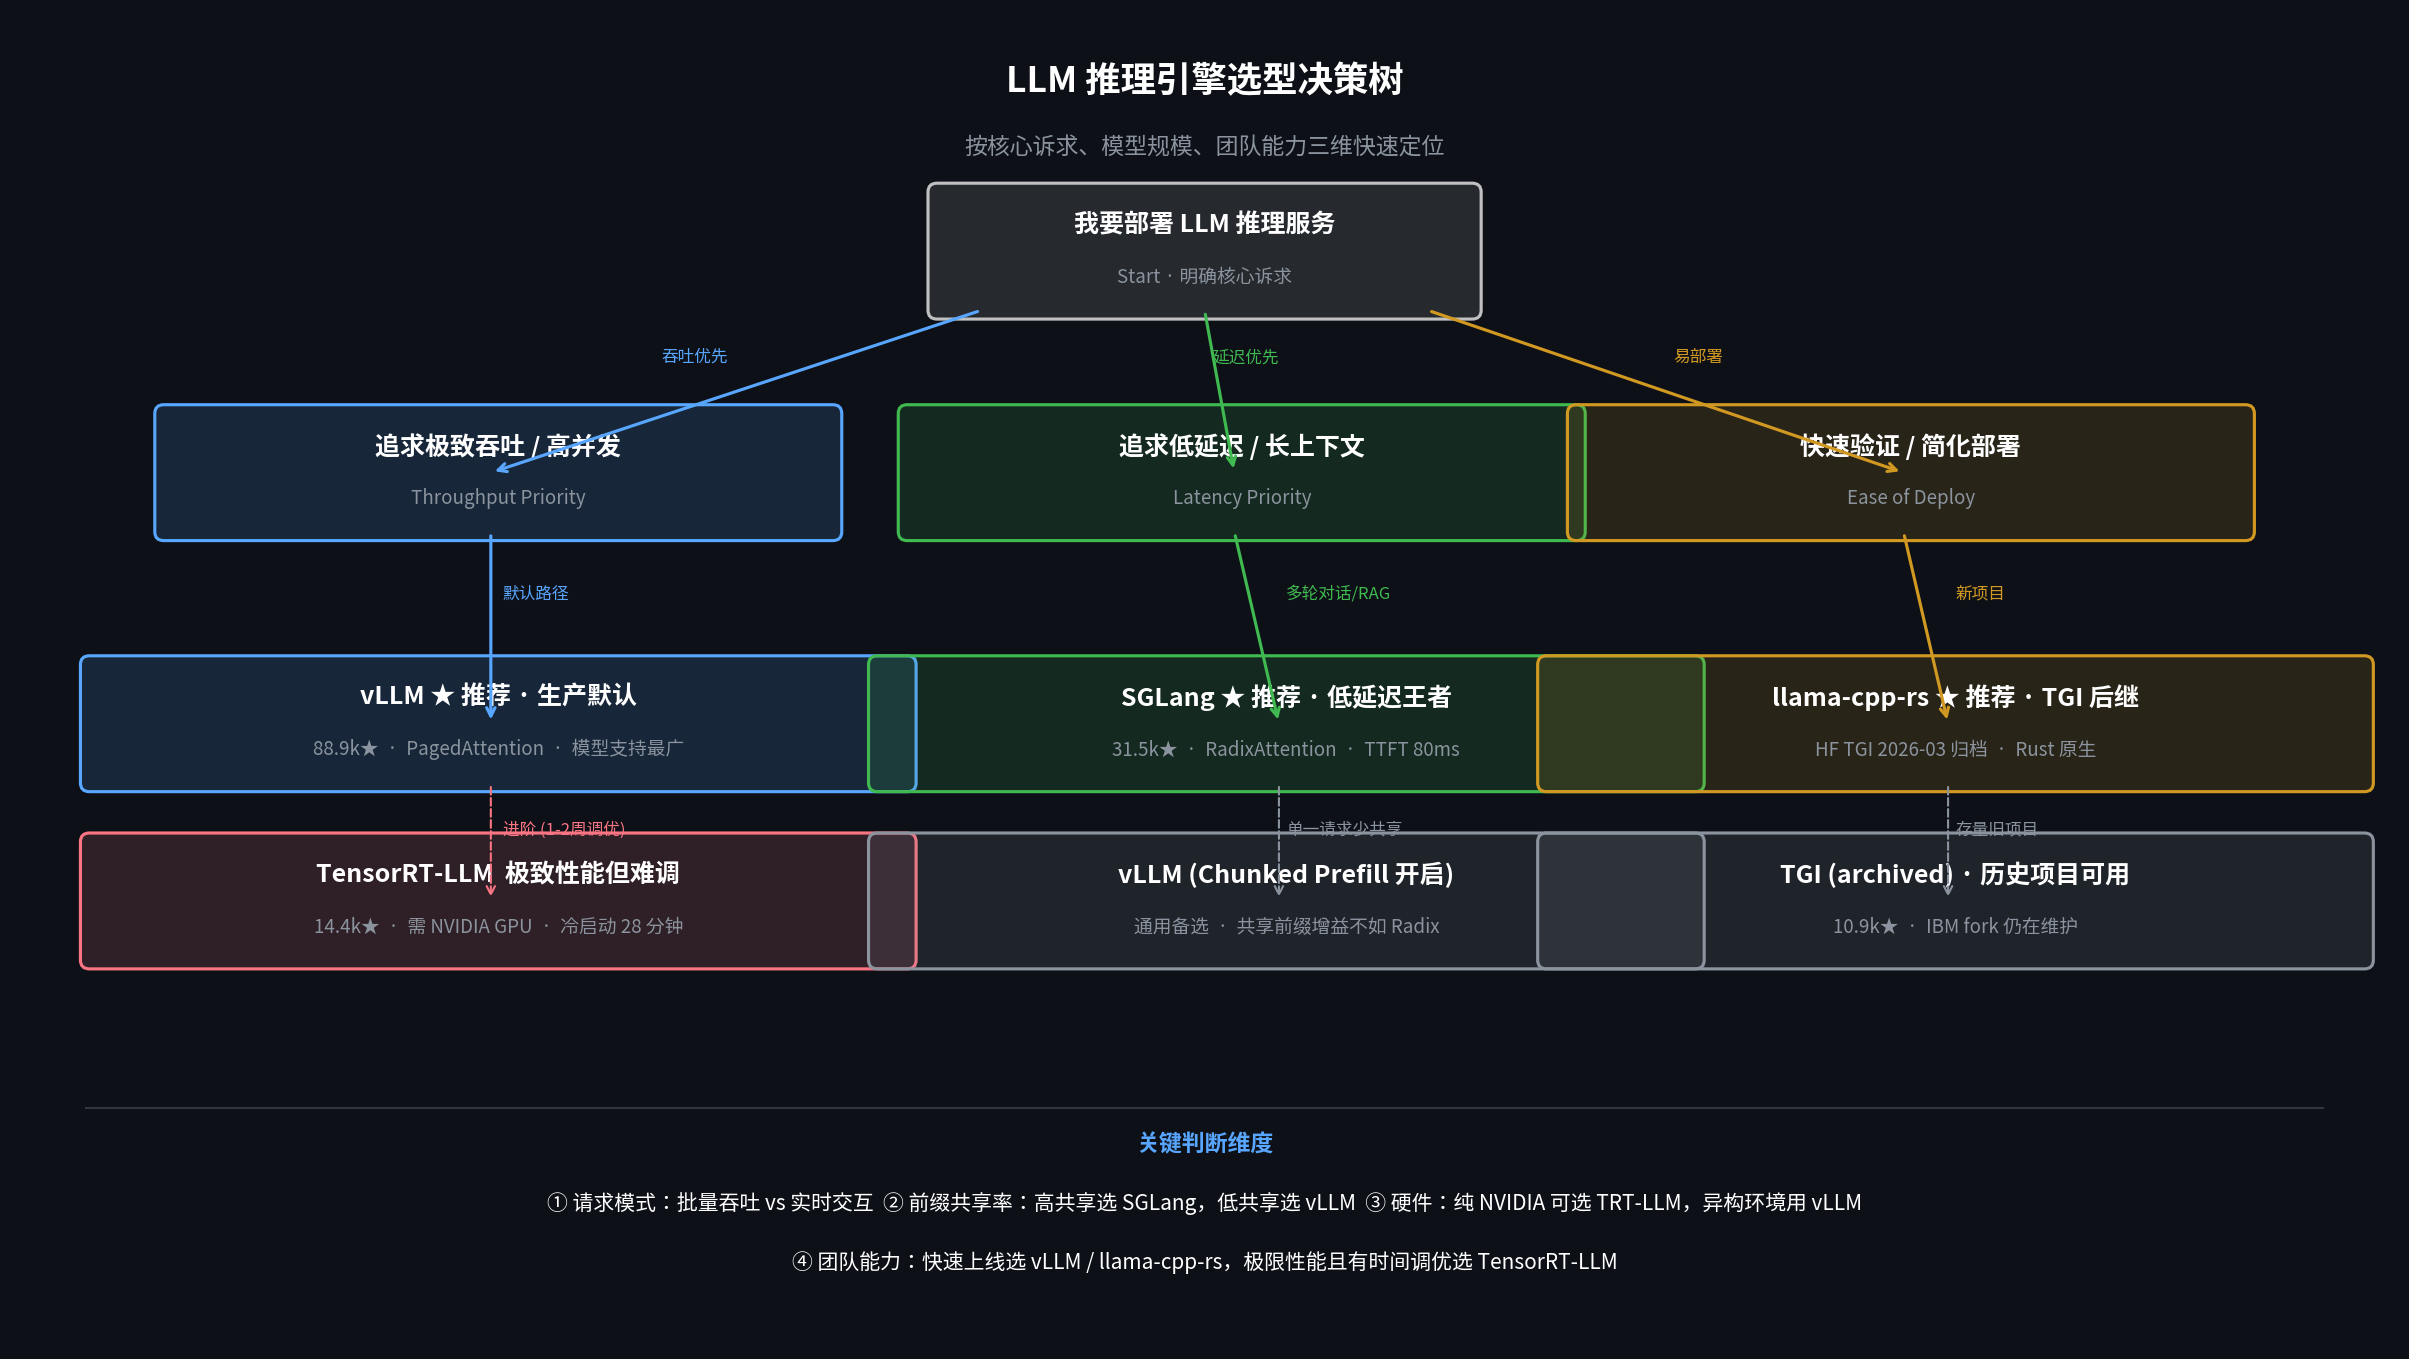
按以下四个维度快速定位:
① 请求模式:批量处理、高并发 API → vLLM;实时交互、多轮对话 → SGLang。
② 前缀共享率:高共享(相同 system prompt、相同检索上下文)→ SGLang 的 RadixAttention 增益最大;低共享(每次 prompt 都不同)→ vLLM 与 SGLang 持平。
③ 硬件条件:纯 NVIDIA H100/B200 集群且模型固定 → 可考虑 TensorRT-LLM;异构环境(含 AMD ROCm、消费级 GPU)→ vLLM 生态最广。
④ 团队调优能力:需要快速上线 → vLLM(Docker 镜像开箱即用);有 1-2 周调优窗口且追求极限 → TensorRT-LLM。
五、部署踩坑实录
坑 1:vLLM Docker 里 --ipc=host 忘了加
症状:多卡 Tensor Parallel 报错 RuntimeError: failed to synchronize。
原因:vLLM 的多 GPU 进程间共享内存默认依赖 shm,Docker 容器默认 shm 大小只有 64MB,跨 GPU 通信会溢出。
修复:
1 | docker run --gpus all --ipc=host \ |
坑 2:SGLang 的 JSON 输出必须用 XGrammar
症状:直接传 response_format={"type":"json_object"},输出偶有 JSON 非法。
原因:SGLang 原生 JSON 校验是后置的,需开启 XGrammar 后端做前缀约束生成。
修复:
1 | import sglang as sgl |
坑 3:TensorRT-LLM 编译失败,CUDA 版本不匹配
症状:trtllm-build 报错 Unsupported CUDA version。
原因:TensorRT-LLM 每个版本绑定的 CUDA/cuDNN/TensorRT 版本是固定的,混用会炸。
修复:使用 NVIDIA 官方 Docker 镜像,锁定版本。
1 | docker pull nvcr.io/nvidia/trtllm:25.03-py3 |
坑 4:GPU 显存跑满后 OOM Kill
症状:vLLM/SGLang 启动几分钟后被 kernel OOM 杀。
原因:--gpu-memory-utilization(vLLM)或 --mem-fraction-static(SGLang)默认值 0.90/0.85 过于激进,模型权重 + KV Cache 超过剩余显存。
修复:显式设低值并计算:
1 | 可用显存 = GPU 总显存 × mem_fraction |
六、总结与选型口诀
一句话选型口诀:
吞吐优先选 vLLM,延迟优先选 SGLang,易部署选 llama-cpp-rs(TGI 已归档),极致性能选 TensorRT-LLM。
给不同团队的建议:
- 中小团队快速上线:直接 vLLM,Docker 一条命令跑起来,社区生态最成熟。
- 做多轮对话/Agent/RAG 的团队:强烈建议用 SGLang,RadixAttention 的增益是实打实的 29%。
- 追求极致性能且有调优资源的企业:TensorRT-LLM 是天花板,但准备好 1-2 周的投入周期。
- 存量 TGI 项目:可继续跑,新项目不要再建。
四款引擎各自有自己的战场。看清自己核心诉求——吞吐、延迟、易部署还是极致性能——就能在 5 分钟内做出不后悔的选型决定。
数据来源:
- vllm-project/vllm · GitHub 88.9k★ · 2026-08
- sgl-project/sglang · GitHub 31.5k★ · 2026-08
- huggingface/text-generation-inference · GitHub 10.9k★ · 2026-08
- NVIDIA/TensorRT-LLM · GitHub 14.4k★ · 2026-08
- Spheron · vLLM vs TensorRT-LLM vs SGLang Benchmarks (2026-03)
- Deploybase · Best LLM Inference Engines 2026
- NVIDIA/TensorRT-LLM · Q3 2026 Roadmap · Issue #15044
🔗 相关文章
❓ 常见问题(FAQ)
Q: vLLM 和 SGLang 应该选哪个?
vLLM 生态更成熟、社区更大、与主流框架兼容性最好,适合大多数场景;SGLang 在长上下文和连续批处理场景有性能优势,且更轻量。如果你的 workload 以长 prompt + 多轮对话为主,可以优先考虑 SGLang。
Q: 单机消费级 GPU 能跑推理服务吗?
可以。vLLM 和 SGLang 都支持 CPU fallback 和低显存模式。8GB 显存可跑 7B 模型,16GB 可跑 13B 模型。注意使用 –max-model-len 限制上下文窗口以控制显存。
Q: 量化(Quantization)对推理质量影响大吗?
INT4 量化通常只损失 1-3% 的生成质量,但推理速度提升 2-4 倍、显存降低 4 倍。对于分类、摘要、代码生成等工程场景,INT4 通常是性价比最高的选择。