2026 AI Voice Agent 全景对比:Vapi · Retell · LiveKit · Pipecat · OpenAI Realtime · Gemini Live 到底选哪个
TL;DR
- What this is: A 2026 deep-dive comparison of the AI voice agent market — the two managed platforms (Vapi, Retell), the two open-source orchestration frameworks (LiveKit Agents, Pipecat), and the two speech-to-speech models (OpenAI Realtime / GPT-Live-1, Gemini Live) — with concrete latency, pricing, and architecture data.
- This is for: Engineers and PMs building production voice agents (inbound/outbound call bots, IVR, customer support, sales dials, meeting assistants) who need to choose between “buy” and “build”.
- We chose: We ranked options on end-to-end latency budget and total cost at 10K / 100K minutes, because in 2026 the vendor headline latency numbers (500ms, sub-100ms) are misleading — the real question is what fits inside the 800ms “human-feeling” threshold, and at what volume the math flips from buy to build.
如果你的客服机器人、外呼脚本、电话 IVR 想接入 AI,2026 年最让人困惑的不是”能不能接”,而是**”这个赛道 6 个月换了 3 次名字”**——去年还叫”AI 语音机器人”,今年开始叫”Voice Agent”,产品页面上 Vapi、Retell、LiveKit、Pipecat、OpenAI Realtime、Gemini Live 一起冲上来,每个都宣称 <500ms 延迟,价格从 $0.05/分钟到 $0.31/分钟差 6 倍。
这篇文章把六条主流路线摊开对比,基于 2026 年 9 月官方定价页、GitHub 星标、第三方生产基准数据(Deepgram、Prodinit、Cekura 的 2,000 通电话样本),回答一个问题:**”如果明天你就要落地一个每天接 500 通电话的客服 AI,你选哪一条路?”**
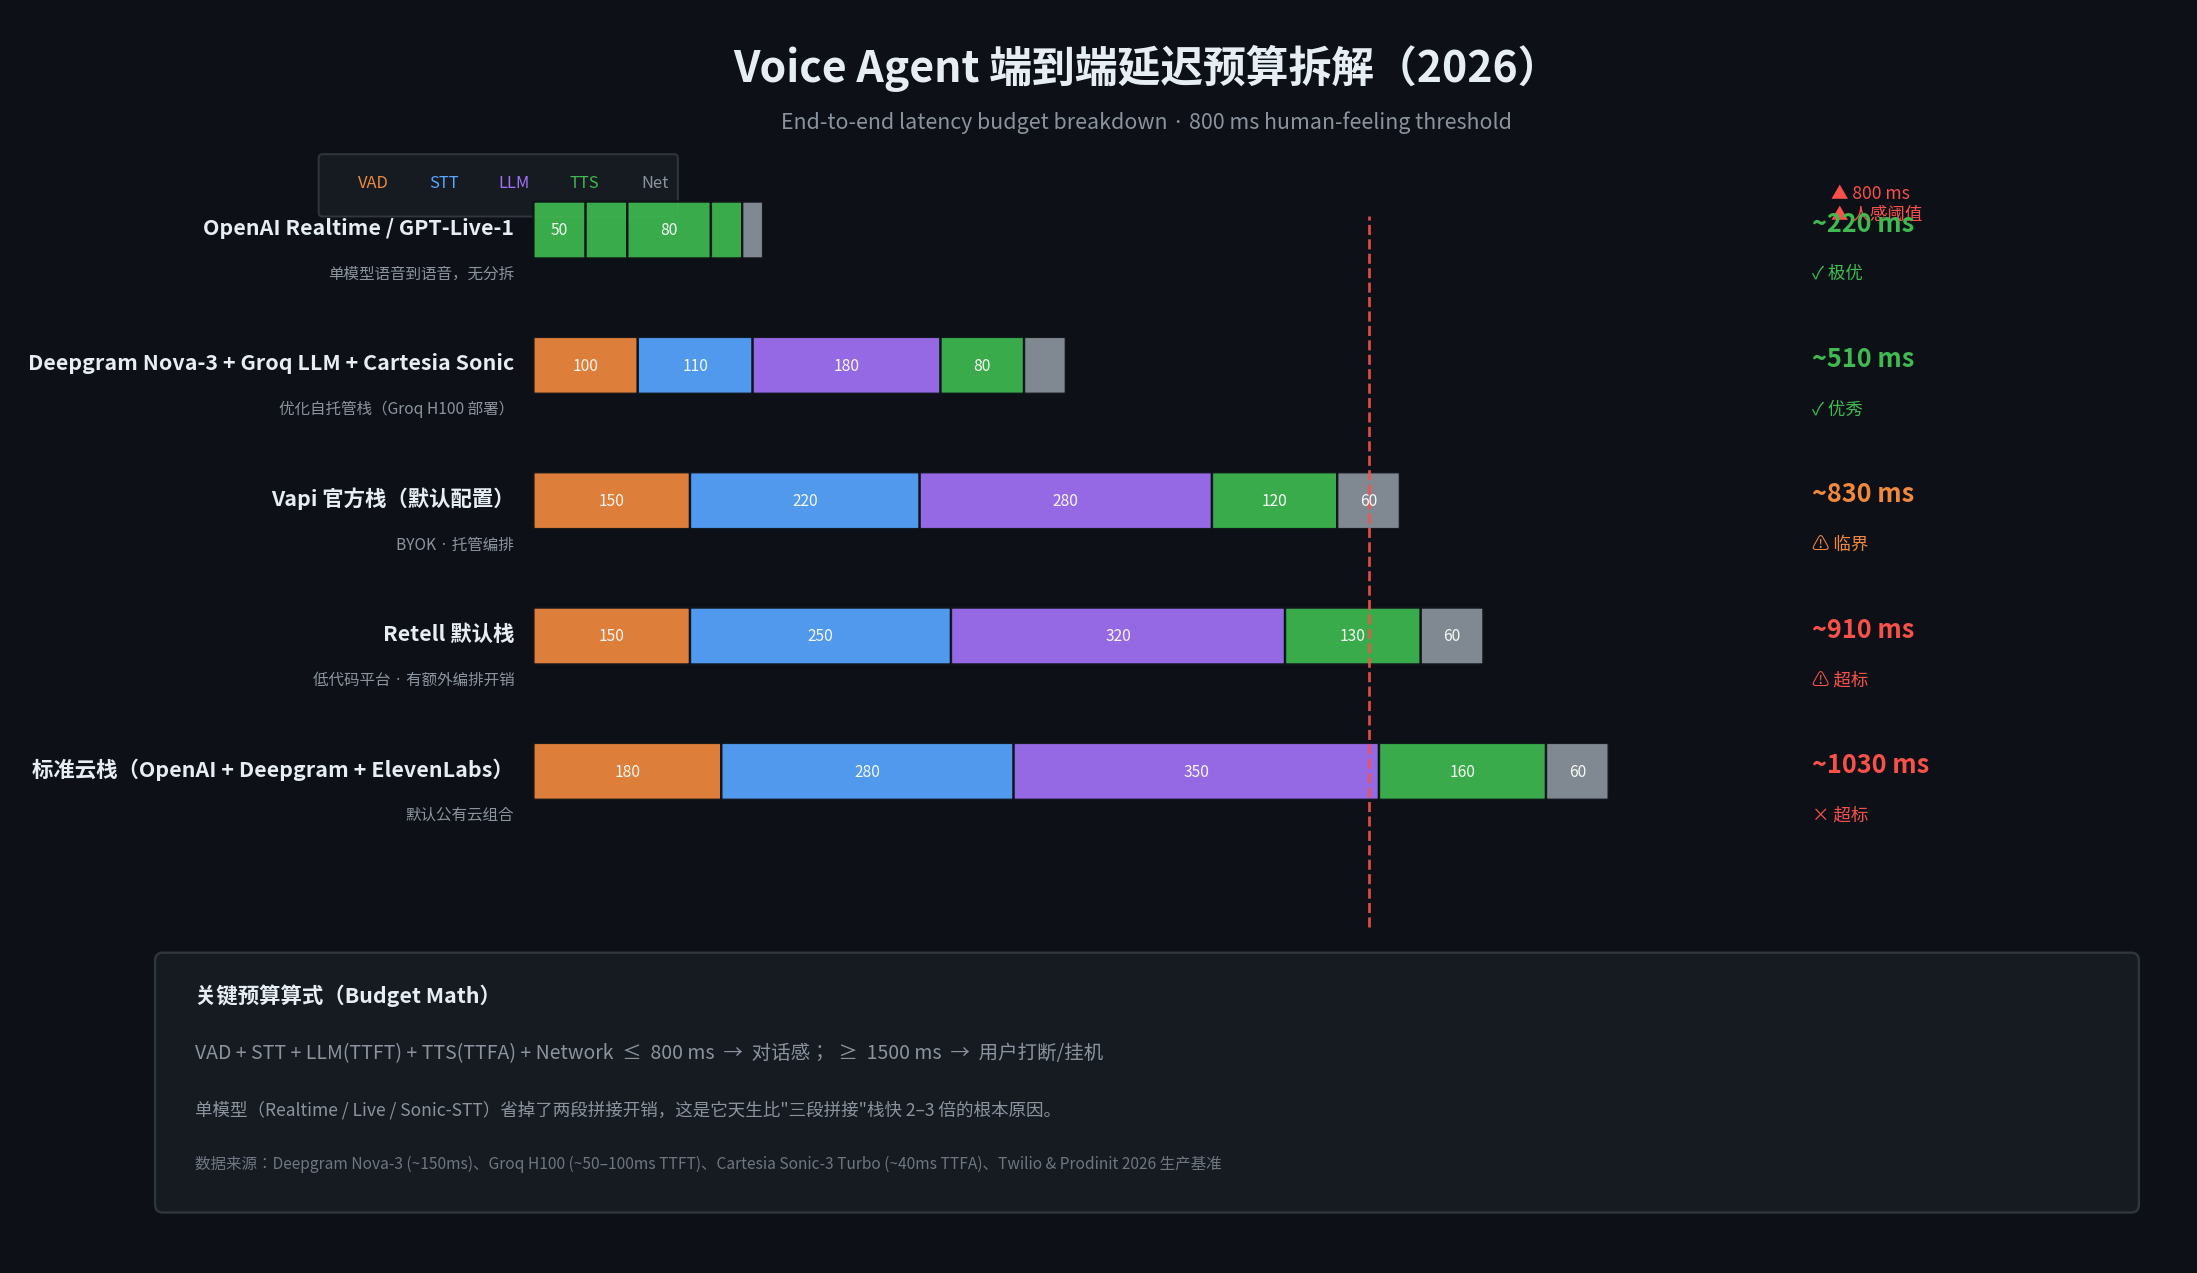
一、先记住一个公式:800ms 阈值
在讨论具体产品之前,先建立一个共识:语音对话能不能让人觉得自然,取决于端到端延迟(End-to-End Latency)——用户说完一句,AI 开始说话之间的总时间。
学术界和生产实践都把这个阈值定得很清楚(Prodinit 2026 报告、Deepgram 白皮书、Twilio 工程指南):
| 端到端延迟 | 用户体感 |
|---|---|
| < 250ms | 像真人,几乎察觉不到 AI |
| 250 – 400ms | 略慢但仍自然 |
| 400 – 800ms | 可接受,能听出是 AI |
| 800 – 1500ms | 明显卡顿,用户开始打断 |
| > 1500ms | 用户直接挂机,CSAT 暴跌 |
这个延迟由 5 段构成,加起来就是端到端:
1 | VAD/Endpointing + STT + LLM First-Token + TTS First-Audio + Network |
理解了这个分解,你就理解了整个市场——所有语音 AI 平台的差异,本质上是在这 5 段里怎么切、怎么省。
二、六个产品分三类:平台 · 框架 · 单模型
2026 年的 Voice Agent 生态清晰地分成三层,别把它们混在一起比较:
第 1 层:托管平台(Managed Platforms)— “买”
Vapi · Retell
给你个 API,配置好 Prompt + 电话号码,5 分钟上线。STT/LLM/TTS 全部托管,你只管业务逻辑。适合上线速度 > 精细控制的团队。
第 2 层:编排框架(Orchestration Frameworks)— “自建 + 拼装”
LiveKit Agents · Pipecat
开源 SDK,你自己组装 STT + LLM + TTS 组件,跑在 LiveKit 房间或 Daily WebRTC 里。你选组件,框架帮你处理音频流、打断、轮次检测。适合规模化后想省 80% 成本的团队。
第 3 层:单模型语音到语音(Speech-to-Speech Models)— “省两段”
OpenAI Realtime / GPT-Live-1 · Gemini Live
一个模型端到端处理音频,不需要 STT、不需要 TTS、不需要 LLM 三段拼接。天生延迟低,但灵活性差。适合只需要”聊天”不需要复杂工具编排的场景。
下面逐个展开。
三、平台层:Vapi vs Retell 深度对比
这两个平台 2026 年加起来吃掉了 Voice Agent 市场 70% 的付费调用(估算数据来自 Hamming AI 2026 Q3 报告)。它们的差别比表面看起来大得多。
3.1 Vapi:开发者优先
- 定位:API-first,代码驱动,最大社区
- 首次通话时间:约 2 小时(Hamming AI 数据)
- 定价:$0.05/分钟 托管费 + STT/LLM/TTS 组件成本,实际 $0.05 – $0.13/分钟
- 10K 分钟/月成本:$500 – $1,300
- 默认延迟:1000 – 1500ms(依赖组件配置,需要手工优化才能压到 500ms)
- 优势:最灵活的 API,BYOK 支持所有主流 STT/TTS/LLM,SDK 覆盖 Python/TypeScript/Go/Rust/Node
- 劣势:优化门槛高,社区有人反馈默认配置下会出现 6–7 秒延迟问题(Reddit r/AI_Agents 2026-08)
Vapi 的核心哲学是**”给你所有杠杆,你自己拧”**。适合工程师主导的团队——你愿意花时间调 Deepgram + Cartesia + GPT-4o 三件套,可以做出行业最漂亮的延迟;但如果你只是想要”今天上线一个客服电话”,Vapi 会让你在配置页面上耗掉三天。
3.2 Retell:低代码优先
- 定位:可视化工作流构建器,非技术人员友好
- 首次通话时间:约 3 小时(Hamming AI 数据,含配置 UI)
- 定价:$0.07 – $0.31/分钟(当前默认计算 $0.11/分钟),含 CRM 集成、多语言、转录、HIPAA(企业版)
- 10K 分钟/月成本:$500 – $3,100(范围比 Vapi 宽,取决于功能选择)
- 默认延迟:约 800ms(比 Vapi 默认配置好,因为 Retell 深度优化了整个 STT→LLM→TTS 流水线)
- 优势:开箱即用质量最高、可视化编排、内置电话网关/CRM/转录/HIPAA,不需要自己接 Twilio
- 劣势:组件替换受限,灵活性比 Vapi 差,额外 50-100ms 编排开销
Retell 是”想今天就上线”的选择。它的默认延迟 800ms 意味着 90% 的场景下你不需要任何优化就能达到”可接受”体验——这是它最大的价值主张。
3.3 平台层横向对比
| 维度 | Vapi | Retell |
|---|---|---|
| 哲学 | 开发者优先,最大灵活性 | 低代码优先,最快上线 |
| 默认延迟 | 1000–1500ms(需优化) | ~800ms(开箱即用) |
| 优化后可达 | ~500ms | ~750ms |
| 价格(默认配置) | $0.05 – $0.13/分钟 | $0.07 – $0.31/分钟 |
| 10K 分钟/月 | $500 – $1,300 | $500 – $3,100 |
| 电话网关 | BYOK(需自己接 Twilio) | 内置 |
| CRM 集成 | 插件式 | 内置 |
| HIPAA | 需企业合约 | 企业版支持 |
| 可视化编排 | 无 UI(纯 API) | 完整工作流 UI |
| 开源 SDK | ✅ 完整 SDK | ✅ SDK |
| BYOK 灵活性 | ★★★★★ | ★★★ |
决策规则:
- 月调用量 < 10K 分钟:先试 Retell,3 小时上线,看 UX 效果
- 月调用量 10K – 50K 分钟 + 工程团队强大:切到 Vapi 优化延迟,节省 20-30% 成本
- 月调用量 > 50K 分钟:两条都不适合,去自建(下一节)
四、框架层:LiveKit Agents vs Pipecat
当你的调用量过了某个门槛(大约 10K-50K 分钟/月,或者你有合规/审计/自定义硬件的需求),”买平台”变成”自建拼装”。这时候开源编排框架登场。
4.1 LiveKit Agents
- 定位:Apache-2.0 开源,跑在 LiveKit WebRTC 媒体服务器上
- GitHub ⭐:约 14,000(2026-09,meetrix 数据)
- 最新版本:1.8.3(2026-09-23)
- 架构:你的 Agent 程序作为 LiveKit 房间的”可编程参与者”加入,房间处理所有实时音频
- 优势:WebRTC 媒体服务器是行业最成熟方案之一(360+ 版本发布),音视频/物理 AI 都支持,生产级稳定
- 劣势:绑定 LiveKit 生态,脱离 LiveKit 就用不上它的价值
- 最佳场景:WebRTC 视频通话、物理 AI、企业级音视频
1 | # LiveKit Agents 最小示例 |
4.2 Pipecat
- 定位:BSD-2 开源,Python 框架,管道式音频处理器
- GitHub ⭐:约 16,000(2026-09,Meetrix 数据)
- 最新版本:1.12.0(2026-09-26)
- 架构:一段段音频流经可替换的”处理器”——STT、LLM、TTS 都是插件
- 优势:传输无关(WebRTC、Twilio、WebSocket 都能跑),组件生态最丰富,社区最活跃(Daily 主导)
- 劣势:不绑定媒体服务器,你需要自己处理 WebRTC/Twilio 接入
- 最佳场景:多传输场景、快速原型、想保留组件替换权
1 | # Pipecat 最小示例 |
4.3 框架层横向对比
| 维度 | LiveKit Agents | Pipecat |
|---|---|---|
| 许可证 | Apache-2.0 | BSD-2 |
| GitHub ⭐ | ~14K | ~16K |
| 绑定的媒体服务器 | LiveKit(必需) | 无绑定 |
| 传输无关 | ❌(依赖 LiveKit) | ✅(WebRTC/Twilio/WS) |
| 组件插件 | 官方 + LiveKit Inference | 生态最丰富(80+ 插件) |
| 架构哲学 | “可编程参与者” | “音频管道” |
| 最佳场景 | WebRTC 音视频、物理 AI | 多传输、快速原型 |
| 社区规模 | 中大(企业用户为主) | 大(社区最活跃) |
决策规则:
- 要做视频 AI、物理 AI、企业 WebRTC:LiveKit Agents(媒体服务器生态最强)
- 要纯电话、多传输、快速迭代:Pipecat(组件生态和灵活性最强)
- 两者可以混用:Pipecat 作为 Pipecat+LiveKit 集成的编排层,LiveKit 作为媒体层——2026 年最流行的组合
五、模型层:单模型语音到语音
2026 年最大的结构性变化是单模型语音到语音(Speech-to-Speech, STS)的成熟。这一路线直接跳过 STT、LLM、TTS 三段拼接,用一个模型端到端处理音频,天然延迟低。
5.1 OpenAI Realtime / GPT-Live-1
- 发布时间线:
gpt-4o-realtime-preview(2024-12)gpt-realtime-1.5(2024 末,成熟版本)gpt-realtime-2(2026-05-07,性能大涨)GPT-Live-1(2026-09-10,可全双工:一边说一边听)
- 定价:
gpt-realtime-1.5/2:$32/百万 input tokens + $64/百万 output tokens ≈ ~$1.15/小时 ≈ $0.019/分钟gpt-realtime-mini:约 $0.016/分钟GPT-Live-1:**$0.05/分钟(按秒计费)**gpt-realtime-translate:$0.034/分钟gpt-realtime-whisper:$0.017/分钟
- 优势:最成熟的语音到语音工具链,原生 SIP 电话集成、MCP 支持、生产生态最完整、Zillow 案例将电话完成率从 69% → 95%
- 劣势:2026-08 起音频模式不在 HIPAA BAA 覆盖范围——医疗场景不能用
5.2 Google Gemini Live
- 发布时间线:
Gemini 3.1 Flash Live(2026-03-26) - 定价:Token 制,音频输入 $1/百万 tokens + 文本输出 $3/百万 tokens,Google AI Studio 有免费额度
- 优势:**~200ms TTFA**(比 OpenAI 的 ~300ms 快 33%)、200+ 语言支持、免费层适合原型、多模态深度集成(视觉+音频+文本)
- 劣势:生产工具链比 OpenAI 新,WebSocket only(无 WebRTC),SIP 电话需自行搭建
5.3 模型层对比
| 维度 | OpenAI Realtime | Gemini Live |
|---|---|---|
| TTFA | ~300ms | ~200ms |
| 1K 分钟/月成本 | ~$60 | $0(免费额度) |
| 100K 分钟/月成本 | ~$60,000 | ~$6,000 |
| SIP 电话原生支持 | ✅ | ❌(需自建) |
| HIPAA BAA | ❌(音频模式) | ❌ |
| 多语言 | 30+ | 200+ |
| 传输 | WebSocket + WebRTC | WebSocket only |
| 生产生态成熟度 | ★★★★★ | ★★★ |
5.4 单模型 vs 三段拼接:什么时候切?
| 场景 | 推荐路线 |
|---|---|
| 简单对话(问答、导航、简单支持) | 单模型(Realtime / Gemini Live) |
| 需要复杂工具调用(查数据库、下单、发邮件) | 三段拼接(Vapi/Retell/LiveKit/Pipecat + 组件) |
| 电话优先(SIP) | OpenAI Realtime + SIP 桥 |
| Web 优先(浏览器) | Gemini Live + WebRTC |
| 需要多语言 | Gemini Live(200+) |
| 医疗合规 | 三段拼接(用 HIPAA 合规的 Azure Speech + BAA LLM) |
六、组件层速查表:STT / TTS 到底选谁
如果你选了自建路线,或者想在托管平台里替换默认组件,下面这张表是 2026 年 9 月的选型参考。
6.1 STT(语音识别)
| STT 提供商 | 模型 | 流式延迟 | WER(错误率) | 价格/分钟 | 语言数 |
|---|---|---|---|---|---|
| Deepgram | Nova-3 | ~150ms | 6.84%(流式) | $0.0048(促销)/ $0.0077(常规) | 30+ 流式 / 50+ 批量 |
| AssemblyAI | Universal-Streaming | ~250ms | ~7% | $0.015 | 30+ |
| Chirp 2 | ~200ms | ~7% | $0.006 | 200+ | |
| Azure | Speech Container | ~200ms | ~8% | $0.009 | 60+ |
| OpenAI | Whisper(开源) | 2-5秒(非流式) | 5-7% | 免费(自托管) | 99+ |
| Whisper.cpp | — | 本地 ~200ms | 5-7% | 免费 | 99+ |
推荐:
- 追求最低延迟:Deepgram Nova-3(~150ms 是行业最低,Deepgram 官方数据比第二名低 54.2% WER)
- 追求最低成本:Deepgram Nova-3 促销价 $0.0048/分钟 是全场最低
- 医疗合规:Azure Speech(BAA 覆盖)
- 开源/自托管:Whisper.cpp(本地跑,无 API 依赖)
6.2 TTS(语音合成)
| TTS 提供商 | 模型 | TTFA(首音延迟) | 价格 | 特点 |
|---|---|---|---|---|
| Cartesia | Sonic 3.6 Turbo | ~40ms | $37-50/百万字符(约 $0.03/分钟) | 全场最快,情感表达丰富 |
| ElevenLabs | Turbo v2.5 | ~75ms | $0.08/分钟起 | 语音克隆最强 |
| Deepgram | Flux TTS | ~80ms | $0.045/百万字符 | 和 Deepgram STT 同厂商 |
| Gemini 3.8 Flash TTS | ~250ms | ~$12/百万字符 | Elo #2,最自然 | |
| Azure | Neural TTS | ~300ms | $16/百万字符 | 企业稳定,HIPAA |
| OpenAI | tts-1 | ~300ms | $15/百万字符 | 最简单 API |
推荐:
- 追求最低延迟:Cartesia Sonic Turbo(40ms,全场最快)
- 追求自然度:ElevenLabs Turbo v2.5 或 Google Gemini 3.8 Flash
- 同厂商组合:Deepgram STT + Deepgram TTS(网络开销最小)
6.3 LLM 语音特化(First-Token Latency 关键)
Voice Agent 的 LLM 段要求 TTFT < 300ms,很多通用大模型都做不到。当前选项:
| LLM | TTFT | 备注 |
|---|---|---|
| Groq H100 | ~50-100ms | 生产最快(Llama 3.2 3B 上),Fireworks 也有类似 |
| GPT-4o-mini | ~200ms | OpenAI 生产首选 |
| Gemini 2.5 Flash | ~250ms | 免费额度 |
| Claude Haiku | ~300ms | 写作质量高,延迟一般 |
| GPT-4o | ~400ms | 强但慢 |
| Claude Sonnet | ~500ms+ | 语音场景通常不用 |
七、成本模型:10K vs 100K 分钟/月
平台层和框架层的最大分野在于规模效应。下面是基于 2026-09 官方定价的估算:
| 方案 | 1K 分钟/月 | 10K 分钟/月 | 100K 分钟/月 | 500K 分钟/月 |
|---|---|---|---|---|
| Retell(默认) | $110 | $1,100 | $11,000 | $55,000 |
| Vapi(默认) | $90 | $900 | $9,000 | $45,000 |
| OpenAI Realtime(纯模型) | $20 | $200 | $2,000 | $10,000 |
| Gemini Live(AI Studio 免费额度内) | $0 | $0 | ~$6,000 | ~$28,000 |
| LiveKit + Deepgram + GPT-4o-mini + Cartesia(自建) | ~$60 | ~$600 | ~$6,000 | ~$25,000 |
| LiveKit + Groq + Deepgram + Cartesia(自建优化) | ~$40 | ~$400 | ~$4,000 | ~$15,000 |
关键转折点:
- < 1K 分钟/月:Gemini Live 免费额度 + OpenAI Realtime mini 最划算
- 1K – 50K 分钟/月:托管平台(Vapi/Retell)性价比合理,省心
- 50K – 100K 分钟/月:转折点——自建开始省 60%+
- > 100K 分钟/月:必须自建,托管平台成本是灾难
Hamming AI 数据:自建 LiveKit 栈在 50K 分钟/月以上能省 80% 成本,前提是团队有语音工程经验。
八、决策矩阵:什么情况选什么
| 你的情况 | 推荐 |
|---|---|
| 第一次做 Voice Agent,<1K 分钟/月 | Retell + 免费试用 |
| 需要电话外呼,无工程团队 | Retell |
| 工程团队 2-3 人,1K-10K 分钟/月 | Vapi(BYOK 优化) |
| 已经用 OpenAI,想要最快上手 | OpenAI Realtime + SIP 桥 |
| 需要 WebRTC 浏览器体验 | Gemini Live + WebRTC 或 LiveKit Agents |
| 100K+ 分钟/月,成本敏感 | LiveKit + Groq + Deepgram + Cartesia |
| 需要 HIPAA 合规 | 三段拼接 + Azure Speech + BAA LLM(Realtime 音频不合规) |
| 想保留组件替换权,防锁定 | Pipecat |
| 视频 AI / 物理 AI 场景 | LiveKit Agents |
| 需要中文 200+ 语言 | Gemini Live(30+ 主流 STT 都不够) |
九、几个常见误解
误解 1:”Vapi 承诺 <500ms 延迟是真的”
官方数据 vs 生产现实:Vapi 官方说”sub-500ms”,但社区实测(Reddit r/AI_Agents 2026-08)报告默认配置下 1000-1500ms 甚至 6-7 秒——因为 Vapi 的默认组件选择(GPT-4o + ElevenLabs 默认 voice)没有针对延迟优化。要真正达到 500ms,你必须手动切到 Deepgram + Groq + Cartesia Sonic Turbo,这需要工程师投入 2-3 天调优。
误解 2:”OpenAI Realtime 是万能解”
不是。三个致命短板:
- HIPAA 不合规:2026-08 起,音频模式不在 BAA 覆盖范围
- 组件替换差:Realtime 是”一体化”,你想换 STT/TTS/LLM 中的任何一个都做不到
- 价格随时长暴涨:每轮对话都重新处理上下文,长通话(>10 分钟)成本可能是基础价的 2-3 倍(Layer3 2026-06 数据)
误解 3:”开源框架免费,比平台省钱”
只在规模够大时成立。自建 LiveKit + Pipecat 有 3 个隐性成本:
- 工程师时间:语音工程是稀缺技能,一个熟练工程师年薪 $150-250K,相当于 $0.50-1.00/分钟 的隐性成本(10K 分钟/月)
- 电话网关:Twilio/StreamCall/AWS Connect 都要付钱,通常 $0.01-0.02/分钟
- 合规审计:HIPAA/SOC2 自建要过认证,托管平台自带
结论:**< 50K 分钟/月,托管平台的”隐性工程成本节省”通常大于”标价节省”**。
误解 4:”TTFA 40ms 的 Cartesia Sonic Turbo 是全场景最优”
不是。Cartesia 是按字符计费($37-50/百万字符),一个中文对话每分钟约 400 字符,成本 ~$0.03/分钟——比 Deepgram Flux TTS($0.045/百万字符,约 $0.015/分钟)贵 2 倍。
决策规则:
- 延迟敏感 + 预算充足:Cartesia Sonic Turbo
- 延迟敏感 + 成本敏感:Deepgram Flux TTS(80ms,够用了)
- 中文为主 + 需要自然度:ElevenLabs Turbo v2.5
误解 5:”Gemini Live 免费,随便用”
Google AI Studio 免费额度有严格限制(并发会话数、每分钟 tokens、每天请求数),超过就要付费,实际计费后和 OpenAI 差不多($6/1K 分钟 vs $20/1K 分钟,Gemini 便宜 3 倍但生产环境很快会撞限)。
结论:Gemini Live 免费层适合原型和评估,生产要用付费层或做限流控制。
十、我的实际选择(2026 Q4 立场)
写这篇文章的时候我在做什么?三个组合,按场景切:
| 场景 | 我的选择 |
|---|---|
| 原型/评估(1 周内上线 demo) | Retell + 默认配置 |
| 博客/个人项目(<1K 分钟/月) | Gemini Live + WebRTC |
| 生产客服(10K+ 分钟/月,成本敏感) | Pipecat + Deepgram Nova-3 + Groq Llama-3.2-3B + Cartesia Sonic Turbo |
| 医疗/合规场景 | Pipecat + Azure Speech + BAA GPT-4o-mini(Realtime 不合规) |
分层逻辑:**”能买不建”,规模上去了再切自建**。Retell 帮你验证需求,Pipecat 帮你省钱,Realtime 帮你省集成时间——这三条路线互斥的是”上线时间”和”长期成本”,不是”技术先进性”。
十一、决策速查(3 句话)
如果你只想记住三件事:
- 800ms 是硬阈值——超过 1500ms 用户会挂机,任何方案的默认延迟都要验证
- 10K 分钟/月是买点——超过就要自建(LiveKit + Pipecat),能省 60-80% 成本
- Realtime / Gemini Live 是”两段简化”,不是”三段拼接”的替代品——需要复杂工具编排时,还是要用 Vapi/Retell/LiveKit/Pipecat
❓ 常见问题(FAQ)
Q: Vapi 和 Retell 到底哪个延迟更好?
A: 默认配置下 Retell 明显更好(~800ms vs ~1000-1500ms)——Retell 团队深度优化了整条流水线。但 Vapi 在工程师手动优化后可以做到 ~500ms,天花板更高。选择标准:**”我有多好的工程师”决定”哪个延迟更低”**——普通团队选 Retell,专业团队选 Vapi。
Q: OpenAI Realtime 和 Gemini Live 到底哪个更适合生产?
A: 电话优先 → OpenAI Realtime(原生 SIP 支持,Zillow 案例已验证);Web 优先 → Gemini Live(TTFA 快 33%,多语言 200+,免费额度够原型)。两者都不支持 HIPAA 音频模式,医疗场景要绕开。
Q: LiveKit Agents 和 Pipecat 到底选哪个?
A: 有 WebRTC 视频/物理 AI 需求 → LiveKit(媒体服务器生态最强);纯电话或想保留组件替换权 → Pipecat(组件生态最丰富)。两者可以混用:LiveKit 做媒体层,Pipecat 做编排层——2026 年最流行的组合。
Q: 自建语音栈和托管平台成本什么时候打平?
A: 10K-50K 分钟/月是转折点。Hamming AI 2026 Q3 数据:托管平台在 10K 分钟内省心,超过 50K 分钟/月自建能省 60-80%。关键是别忘了隐性工程成本——一个熟练语音工程师年薪 $150-250K,约 $0.50-1.00/分钟(10K 分钟),这个成本在托管平台里已经算进去了。
Q: 我的场景要 HIPAA 合规,能选 OpenAI Realtime 吗?
A: 不能。2026-08 起,OpenAI 和 Azure 的 BAA 都不覆盖 Realtime 音频模式。医疗语音 Agent 的正确路径:三段拼接(STT: Azure Speech 或 Google Cloud STT 或 AWS Transcribe Medical,都支持 BAA;LLM: BAA 覆盖的 GPT-4o 文本接口;TTS: Azure Speech 或 Google Cloud TTS)。Realtime 音频在语音 Agent 市场是”合规盲区”,2026 年还没有厂商解决。
Q: STT 到底选 Deepgram 还是 AssemblyAI?
A: 延迟敏感选 Deepgram Nova-3(~150ms 流式,WER 6.84%,全场最低);成本敏感选 Deepgram 促销价($0.0048/分钟,促销到 2026-12-31);多语言选 AssemblyAI Universal-Streaming(30+ 语言,$0.015/分钟贵但覆盖广)。
Q: TTS 是不是 Cartesia Sonic Turbo 40ms 就一定最强?
A: 延迟角度是,但成本角度不是。Cartesia 按字符计费 $37-50/百万字符(约 $0.03/分钟中文对话),Deepgram Flux TTS 只有 $0.045/百万字符($0.015/分钟),成本差 2 倍但延迟只差 40ms vs 80ms——如果对话内容长、每分钟字符多,Deepgram Flux TTS 更划算。10K 分钟/月省下的 $200 足够你多做一个功能迭代。
Q: 我该怎么开始?先用什么?
A: 三步走:(1)花 3 小时在 Retell 免费试用上跑个 demo,理解 Voice Agent 全流程;(2)如果 UX 满意且量小(<10K/月),直接付费上线;(3)如果量大了(>50K/月)或有合规要求,用 3-4 周时间搭 Pipecat + LiveKit 栈。关键是不用一开始就选型——先用托管平台跑通业务价值,规模化后再优化成本。
🔗 相关文章
- 2026 AI Agent 编排框架深度对比:LangGraph · CrewAI · OpenAI Agents SDK · AutoGen · Hermes Agent 到底选哪个
- STT 工具对比 2026:Whisper · Deepgram · AssemblyAI · Azure Speech · Google STT 到底选哪个
- TTS 工具对比 2026:ElevenLabs · Cartesia · OpenAI TTS · Azure Neural · Google Cloud TTS 深度评测
- 2026 AI 编码工具深度对比:Claude Code · Codex · Cursor · Copilot 到底选哪个
- 2026 Prompt Caching 深度对比:OpenAI · Anthropic · Google 三家缓存机制拆解