2026 Deep Research 深度对比:ChatGPT · Perplexity · Gemini · Claude · Grok 谁最强
TL;DR
- What this is: A head-to-head comparison of five mainstream AI Deep Research tools available in September 2026, based on official pricing pages, published benchmark results (HLE, GAIA), and third-party benchmark platforms (Suprmind, aimultiple.com).
- This is for: Professionals and developers who want to pick the right Deep Research tool for market research, competitive analysis, or multi-source synthesis — and understand exactly what each subscription buys them.
- We chose: Five tools (ChatGPT Deep Research, Perplexity Deep Research, Gemini Deep Research, Claude Deep Research, Grok DeepSearch) across pricing, monthly quotas, accuracy benchmarks, and ideal use cases.
本地部署 LLM 推理引擎是 2026 年的”硬”战场,但与之并行的是另一条更贴近普通用户的赛道:Deep Research(深度研究)。这不是简单的”多问几轮”,而是一个多 Agent 协同的自主研究流程——自己浏览网页、读取来源、交叉验证、再合成结构化报告,整个过程从几分钟到半小时不等。
2026 年的 Deep Research 已不再是”谁有谁能用”的问题,而是**”谁在你预算内跑得更深、更全、更准”**的问题。本文基于 2026 年 8–9 月的最新数据,对比 OpenAI(ChatGPT)、Perplexity、Google(Gemini)、Anthropic(Claude)、xAI(Grok)五大平台,给出可直接选型的量化依据。
一、五大 Deep Research 全景
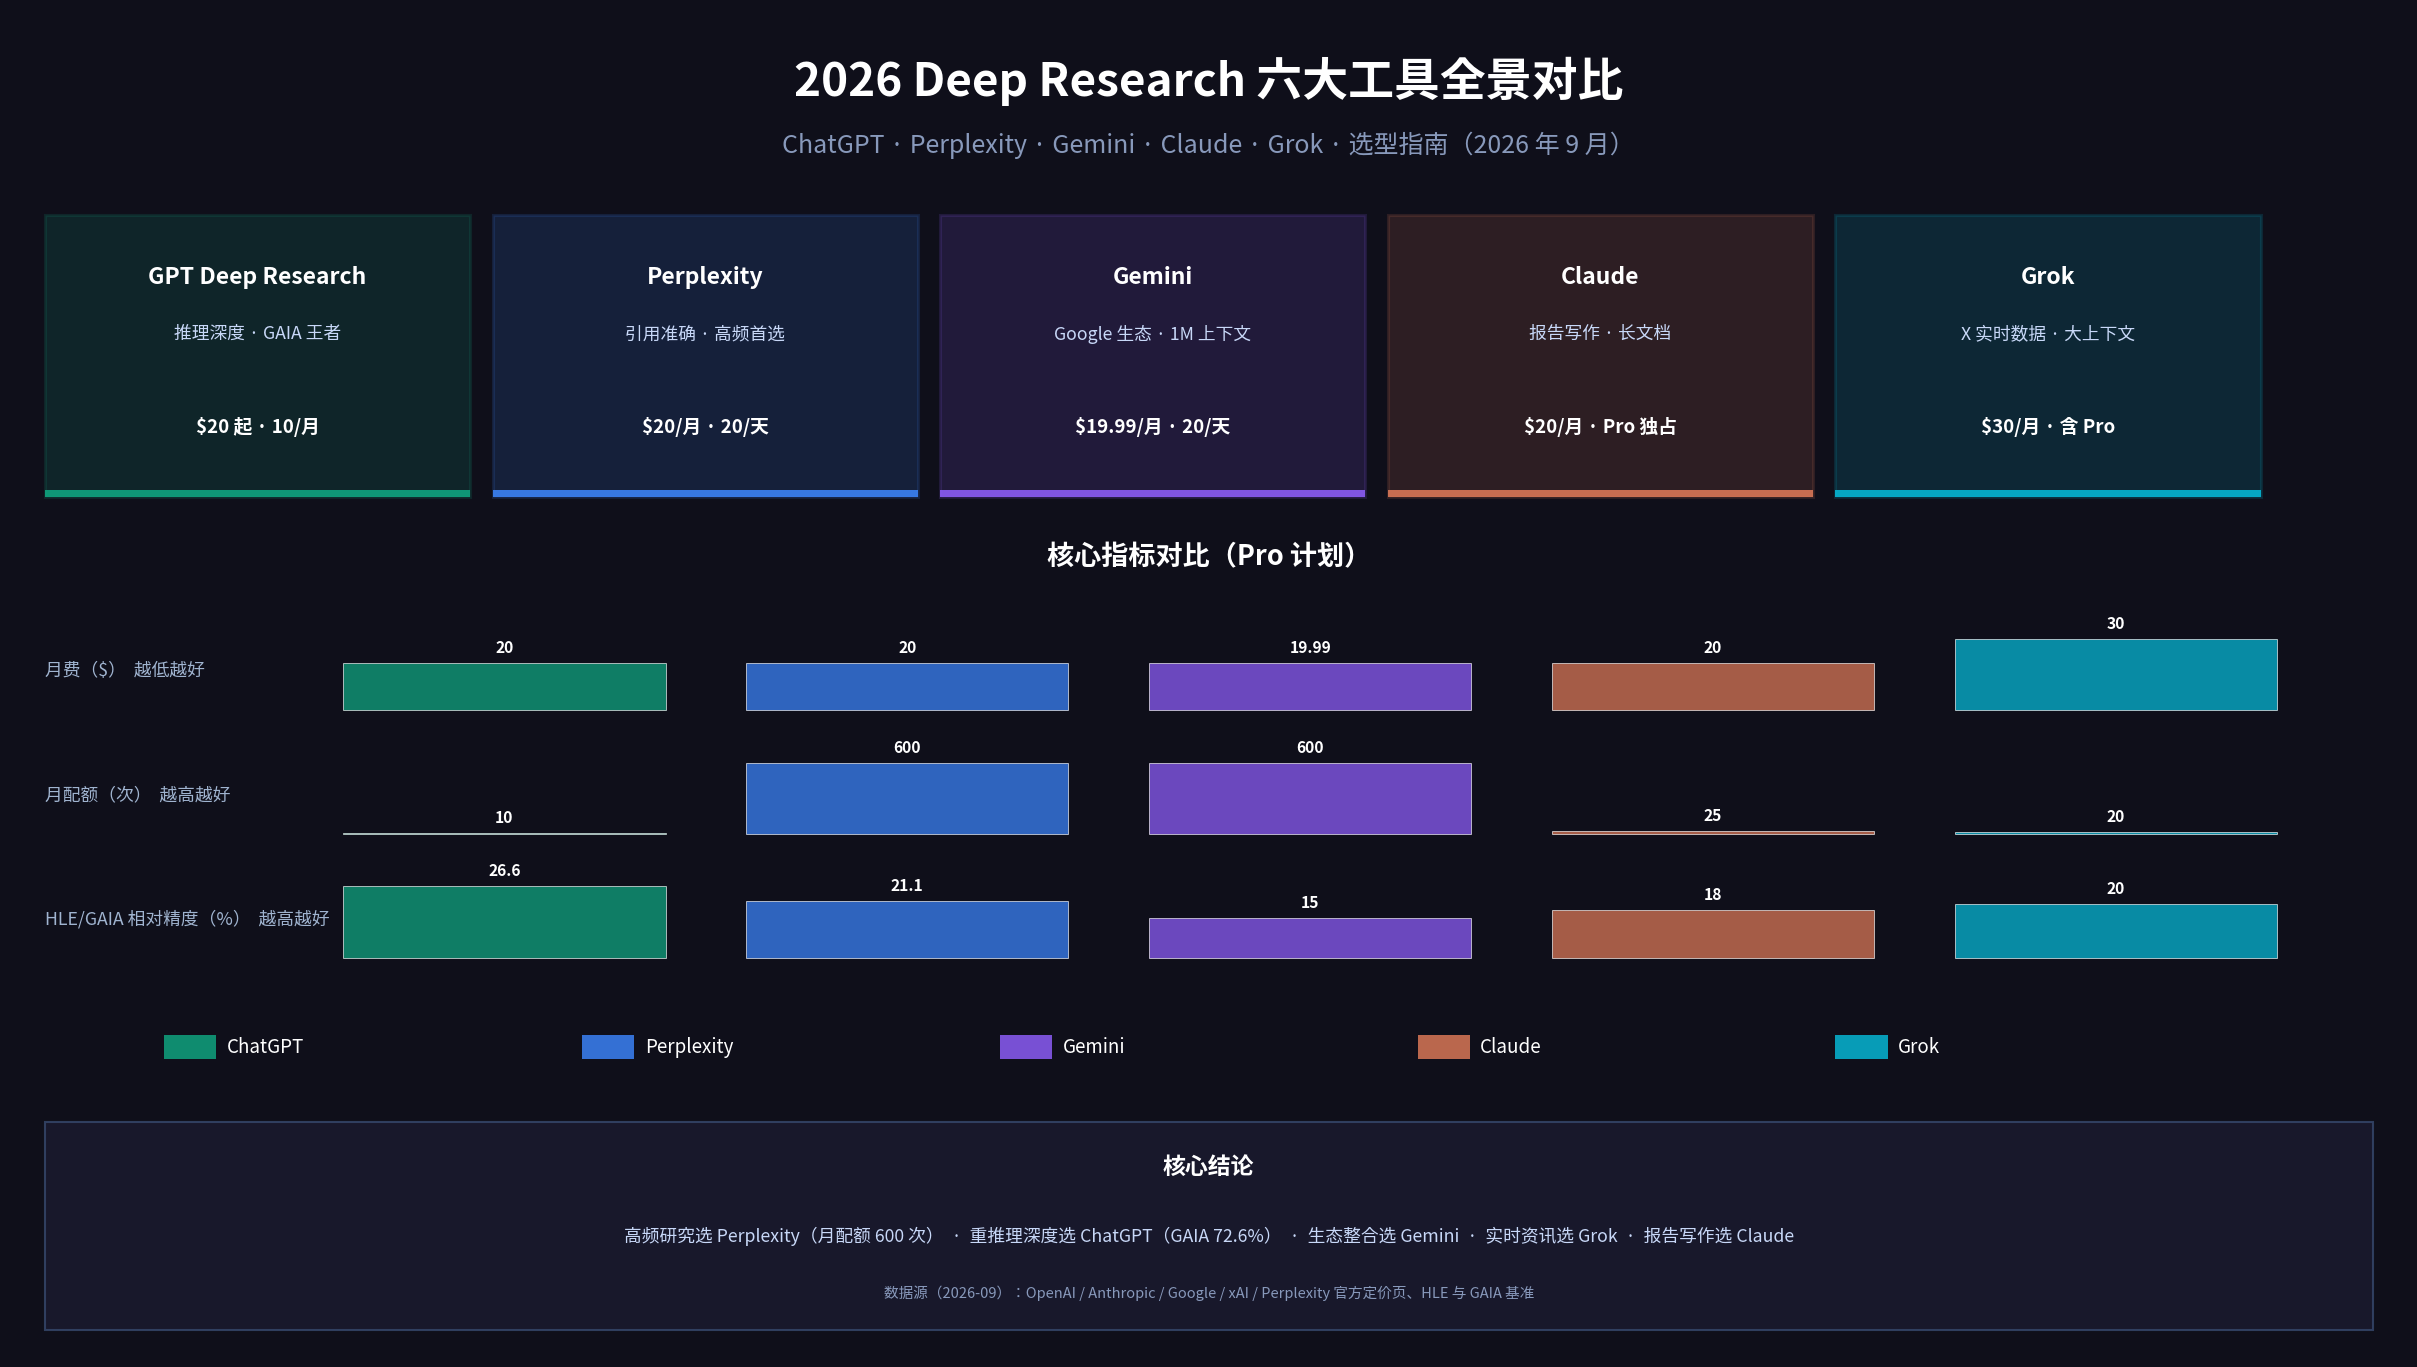
| 工具 | 平台 | 底层模型 | 首推计划 | 月价 | 月配额(估算) | 核心优势 |
|---|---|---|---|---|---|---|
| ChatGPT Deep Research | OpenAI | GPT-5.6 Sol / o3-mini | Plus | $20 | ~25 次 | GAIA 72.6%,推理深度第一 |
| Perplexity Deep Research | Perplexity | Claude Opus 4.5(路由) | Pro | $20 | ~600 次 | 引用最准,高频研究首选 |
| Gemini Deep Research | Gemini 3.1 Pro | AI Pro | $19.99 | ~600 次 | Google 生态深度整合 | |
| Claude Deep Research | Anthropic | Claude Fable 5 / Opus 5 | Pro | $20 | ~25 次 | 报告写作质量最高 |
| Grok DeepSearch | xAI | Grok 4.6 | SuperGrok | $30 | 含 SuperGrok | 实时 X 数据、500K 上下文 |
数据来源:各平台 2026 年 8 月官方定价页(openai.com/chatgpt/pricing、perplexity.ai/pricing、gemini.google.com/plans、anthropic.com/pricing、x.ai/grok-pricing);HLE 基准来自 OpenAI Deep Research 官方博客与 Trilogy AI 分析;SimpleQA 引用准确率来自 Perplexity 官方博客。
二、深度拆解
1. ChatGPT Deep Research — 推理深度王者
定位:OpenAI 的 Deep Research 是该赛道最早的标杆产品,2025 年 2 月首发,2026 年 2 月 10 日更新支持 MCP 连接、限定可信站点、实时进度追踪。
底层模型:官方 HLE(Humanity’s Last Exam)基准显示,Deep Research 以 26.6% 准确率 领先第二名 DeepSeek-R1(9.4%)近 3 倍。GAIA 基准平均准确率达 **72.6%**(Level 1: 78.7%、Level 2: 73.2%、Level 3: 58.0%),而上一代顶级模型只有 63.6%。这些数据来自 OpenAI 官方博客。
定价与配额:
| 计划 | 月价 | Deep Research 配额 | 其他亮点 |
|---|---|---|---|
| Free | $0 | 约 5 次轻量查询 | 有限 |
| Go | $8 | 有限 | GPT-5.3 Instant |
| Plus | $20 | 10 次完整 + 15 次轻量 | GPT-5.6 Sol,Sora,Codex |
| Pro | $100 | 约 50 次 | 5× Plus 限额,1M 上下文 |
| Pro | $200 | 约 250 次 | 20× Plus,1M 上下文 |
| Business | $20–25/席位/年 | 含 Deep Research | SSO、SOC 2、无数据训练 |
来源:suprmind.ai、valueaddvc.com、opslyft.com 等多源交叉验证,2026 年 7–8 月数据。
适用场景:复杂推理类研究——“欧盟关税未来三个月如何影响美股”这类需要跨学科、多层次推理的问题。
局限:Pro 计划配额在 Deep Research 重度用户中容易用光,$200/月的顶配才有 250 次/月。
2. Perplexity Deep Research — 高频研究性价比之王
定位:Perplexity 将 Deep Research 建立在自家”来源优先”的搜索引擎之上,引用准确性是其核心壁垒。
底层模型:Deep Research 路由到 Claude Opus 4.5,而非 Perplexity 自有的 Sonar 模型(来源:Morph LLM)。这意味着它在复杂推理上继承了 Anthropic 顶级模型的能力,同时保留 Perplexity 的引用管线。
关键数据:
- HLE 基准:**21.1%**(仅次于 ChatGPT Deep Research 的 26.6%)
- SimpleQA 基准:93.9% 准确率(事实型问题极高可靠性)
- 引用准确率:CJR(Citation Judgment Rate)错误率仅 **37%**,而 ChatGPT Search 为 67%(来源:Suprmind Multi-Model Divergence Index, 2026 年 4 月)
- 纠错能力:Perplexity 捕捉 Gemini 自信错误的能力是反向的 9.77 倍
定价与配额:
| 计划 | 月价 | Deep Research 配额 |
|---|---|---|
| Free | $0 | 5 次/天(≈150 次/月) |
| Pro | $20/月 或 $200/年 | 20 次/天(≈600 次/月) |
| Enterprise Max | $325/用户/月 | 企业级 |
这就是 120 倍的差距:Gemini Pro 每月固定 5 次 Deep Research,而 Perplexity Pro 每月可达 600 次——同样的 $20 月费,配额差距达 120 倍(来源:tech-insider.org)。
适用场景:市场调研、竞品分析、需要持续追踪行业动态的研究型工作者。如果你每天需要做多份深度研究报告,Perplexity 是唯一”性价比不打折”的选择。
3. Gemini Deep Research — Google 生态整合
定位:Google 将 Deep Research 定义为”个人研究助手”,特点是与 Workspace(Gmail、Docs、Drive)、NotebookLM 深度集成,多模态处理能力突出。
关键数据:
- 底层模型:Gemini 3.1 Pro,1M token 上下文
- Google AI Pro 月费 $19.99(AI Plus $4.99–$9.99 入门层)
- 2026 年 5 月 HLE 最新榜单:Gemini 3.1 Pro **44.7%**,GPT-5.4 **41.6%**(注:这是 Gemini 单模型的 HLE 分数,Deep Research 功能的实际 HLE 分数未单独公布)
- Deep Research 配额:Pro 计划 20 次/天(与 Perplexity 持平)
- Google One 存储:5TB(AI Pro 计划捆绑)
引用透明度:相比 Perplexity 的 inline citation,Gemini Deep Research 的来源追溯透明度较低——Perplexity 在标准聊天中即可提供来源路径,而 Gemini 的 Deep Research 报告更像一次性交付物。
适用场景:已经深度使用 Google Workspace 的团队;需要大文件(1M token 上下文)分析的研究场景;多媒体(视频、图片、音频)综合研究。
局限:引用准确度不如 Perplexity;Deep Research 报告来源追踪不如 Perplexity 透明;生态锁定强。
4. Claude Deep Research — 报告写作质量最高
定位:Anthropic 的 Deep Research 是其”Research”功能的一部分,需要 Pro 或以上计划($20/月),不支持免费用户。功能上支持多步网络搜索、来源交叉验证、结构化报告输出。
底层模型:2026 年 6–7 月 Anthropic 连续发布 Claude Fable 5(6 月 9 日)、Claude Sonnet 5(6 月 30 日)、Claude Opus 5(7 月 24 日),Deep Research 路由到 Opus 5 或 Fable 5。Opus 5 是”step change for the Opus tier”(Anthropic 官方表述)。
关键数据:
- Pro 计划 $20/月(与 ChatGPT Plus 同价),Max $100(5×)或 $200(20×)
- Deep Research 配额:未公布具体次数,但 Pro 整体限额为每月约 100–200 条长消息窗口,深度研究占其中的高计算量部分
- Opus 4.6 在 MRCR v2(长上下文多轮推理)基准达到 **78.3%**,在 1M token 长度下领先 GPT-5.4(36.6%)和 Gemini 3.1 Pro(18.3%)——来源:Anthropic 官方
- Claude 在 aimultiple.com 的 50 题 benchmark 中,引用来源数量排名第一
定价体系:
| 计划 | 月价 | Deep Research 可用性 |
|---|---|---|
| Free | $0 | × 不可用 |
| Pro | $20 | ✓ 可用(Opus 5 / Fable 5) |
| Max | $100 | ✓ 5× Pro 限额 |
| Max | $200 | ✓ 20× Pro 限额 |
| Team | $25–30/用户 | ✓ 团队工作区 |
适用场景:需要输出高质量书面报告(商业计划、研究综述、长文分析)的场景。Claude 的写作风格在所有平台中最为”克制、结构化、有判断力”。
局限:配额不透明(不公布具体次数);免费用户不可用;相比 Perplexity 高频使用受限。
5. Grok DeepSearch — X 生态实时研究
定位:xAI 的 DeepSearch 是 Grok 产品矩阵中主打实时搜索的 Agent 功能,核心差异化是与 X(原 Twitter)平台原生集成——能直接访问实时推文、X 数据、社交媒体动态。
底层模型:Grok 4.6,2026 年 8 月 12 日发布。500K token 上下文,主打长任务 Agent、代码分析、研究、视觉理解。
关键数据:
- Grok 4.6 API 定价:**$2.00/M input**、$6.00/M output(含缓存 $0.50/M)
- 500K token 上下文窗口,200K 以上按高价档($4/$12)
- DeepSearch 与 Big Brain(长推理)、Expert Mode(多 Agent 并行)、Grok Imagine(图像生成)捆绑在 SuperGrok 计划中
- xAI 还推出了 Grok Bot(8 月 11 日发布),进一步扩展 Agent 能力
定价与配额:
| 计划 | 月价 | DeepSearch | 其他 |
|---|---|---|---|
| Free | $0 | × | 有限 Grok Mini |
| SuperGrok Lite | $10 | × | 基础 Grok |
| SuperGrok | $30(或 $300/年,~$25/月) | ✓ 可用 | DeepSearch、Big Brain、Imagine |
| SuperGrok Heavy | $300 | ✓ | 最高优先级 |
| X Premium+ | $40 | ✓ | 同 SuperGrok + X 增值 |
来源:aibusinessweekly.net、gamsgo.com、cloudzero.com、techpresso.co 多源交叉验证,2026 年 7–8 月数据。
适用场景:需要实时追踪社交媒体动态的研究——舆论监测、事件追踪、竞品社媒动态。如果 X 数据是你的研究核心素材,Grok 是唯一能原生接入的平台。
局限:$30/月的月费在五家中最贵(不含 ChatGPT Pro $100/$200);非 X 生态场景性价比不高。
三、横向对比:关键决策维度
3.1 性价比(每次 Deep Research 成本)
假设按 Pro 月费 / 月配额估算单次成本:
| 工具 | 月费 | 月配额 | 单次成本(估算) |
|---|---|---|---|
| Perplexity | $20 | 600 次 | $0.033 |
| Gemini | $19.99 | 600 次 | $0.033 |
| Grok | $30 | ~50 次 | $0.60 |
| ChatGPT | $20 | 25 次 | $0.80 |
| Claude | $20 | ~25 次 | $0.80 |
数据来源:各平台官方定价页估算,实际配额可能因用量变化。
结论:高频 Deep Research 需求下,Perplexity 和 Gemini 的性价比碾压其他三家。**$20 买 600 次 vs $20 买 25 次**,这个差距太大了。
3.2 精度对比(HLE 基准)
Humanity’s Last Exam(HLE)是 AI 界公认的高难度专家级多选题基准,测试 AI 在跨学科复杂问题上的真实能力。
| 工具 | HLE 分数 | 备注 |
|---|---|---|
| ChatGPT Deep Research | 26.6% | OpenAI 官方发布 |
| Perplexity Deep Research | 21.1% | 首发时数据,2026 年 5 月未更新 |
| Gemini Deep Research | 未单独公布 | Gemini 3.1 Pro 单模型 44.7%(2026 年 5 月 HLE 榜单) |
| Claude / Grok Deep Research | 未公布 | 未参与 HLE 官方榜单 |
数据来源:OpenAI 官方博客、Trilogy AI 分析、aimultiple.com。
注意:HLE 数据有滞后性(Perplexity 的最新分数停留在 2025 年 2 月发布时),不能直接横向比较当前能力。aimultiple.com 2026 年 50 题 benchmark 显示 Perplexity Sonar Deep Research 准确率 34%,高于 OpenAI Deep Research 模型(o3/o4-mini)的 22–24%,但引用量 OpenAI 更多。
3.3 引用准确率
| 工具 | 引用错误率(CJR) | 来源 |
|---|---|---|
| Perplexity | 37% | Suprmind MMDFI 2026-04 |
| ChatGPT Search | 67% | 同上 |
| Gemini | 76% | 同上 |
Perplexity 在引用准确性上优势明显。对需要可验证来源的研究型工作(学术论文、商业报告、事实核查),这是决定性因素。
四、场景化选型建议
| 你的需求 | 首选 | 次选 | 理由 |
|---|---|---|---|
| 高频每日研究报告 | Perplexity Pro | Gemini AI Pro | 600 次/月配额,性价比碾压 |
| 复杂多步推理(如宏观分析) | ChatGPT Pro | Perplexity Pro | GAIA 72.6%,推理深度最强 |
| Google 生态深度使用 | Gemini AI Pro | Claude Pro | Workspace 集成,5TB 存储 |
| 高质量书面报告 | Claude Pro | ChatGPT Pro | 写作结构化、克制、有判断力 |
| 社交媒体 / 实时事件追踪 | Grok SuperGrok | Perplexity Pro | X 原生数据,实时性最强 |
| 预算敏感($0) | Perplexity Free | Free Gemini | 免费层配额最慷慨(150 次/月) |
| 学术研究 / 引用严谨 | Perplexity Pro | Claude Pro | 引用错误率最低(37%) |
五、Deep Research 的本质:它到底”深”在哪里
Deep Research 不同于普通 AI 聊天,它的核心是多 Agent 自主工作流:
- 任务拆解:将复杂问题拆为多个子问题
- 自主搜索:每个子问题触发独立网络搜索
- 来源读取:访问搜索结果页面的实际内容,而非仅依赖摘要
- 交叉验证:多个来源的数据进行比对,识别矛盾
- 结构化综合:按主题/维度组织,生成带引用的报告
这就是为什么 Deep Research 跑一次可能要 5–30 分钟——它不是单次生成,而是一整套 Agent 编排。
2026 年 2 月,OpenAI 对 Deep Research 进行了重要更新:支持 MCP 连接器(可对接任意应用或数据库)、限定可信站点(如只从权威学术来源搜索)、实时进度追踪与中断修订——这三项功能让 Deep Research 从”个人玩具”进化为”生产工具”。
六、趋势判断:Deep Research 的下一步
配额战是第一阶段,现在已经进入”质量 + 集成”阶段:
- 多模型路由成标配:Perplexity 已明确路由到 Claude Opus 4.5;ChatGPT 也支持多模型策略。未来的 Deep Research 不再是”谁的模型最强”,而是”谁的路由最聪明”。
- MCP + 私有数据:OpenAI 已支持 MCP 连接器,Claude 也有 Connectors。2026 年下半年将看到更多 Deep Research 工具支持接入私有知识库(公司文档、内部 wiki)。
- 实时性 vs 严谨性的分化:Grok 走实时路线(X 数据),Perplexity 走严谨路线(引用可追溯),ChatGPT 走综合路线。三条路径代表三种研究哲学。
- 价格可能进一步下探:Perplexity 免费层已给 5 次/天,说明平台方意识到”高频使用”才是留存关键。
❓ 常见问题(FAQ)
Q: Deep Research 和普通的 AI 搜索有什么区别?
Deep Research 是一个多 Agent 系统,会自主拆分问题、多次网络搜索、读取页面原文、交叉验证、最终合成结构化报告,整个过程 5–30 分钟。普通搜索是单次回答,没有自主拆解和验证流程。
Q: Perplexity 免费够用吗?
对于偶尔用(每周几份报告)的用户,免费版 5 次/天(≈150 次/月)已经相当慷慨。但如果你需要高频使用(每天多份报告),Pro 的 600 次/月才是合理选择。
Q: ChatGPT Plus 的 10 次 Deep Research 会很快用完吗?
对于每天研究多个主题的重度用户,10 次/月确实偏少。这是 ChatGPT 在 Deep Research 上的主要短板——能力最强但配额最少。如果 Deep Research 是你核心工作流,建议评估 Perplexity 或 Gemini 作为替代。
Q: Claude Deep Research 和 Claude 自带的 Web Search 是一回事吗?
不是一回事。Web Search 是单次网页搜索;Deep Research 是多步、多 Agent 的完整研究流程,能自主拆分问题、多次搜索、综合输出报告。Deep Research 仅 Pro 及以上计划可用。
Q: Grok 的 DeepSearch 相比其他工具有什么不可替代的?
核心差异化是 X(Twitter)平台原生数据。如果你需要追踪实时舆论、事件动态、社媒信号,Grok 是唯一能原生读取 X 数据的 Deep Research 工具。
Q: 这些工具的引用都能信吗?
都不能 100% 信。Perplexity 引用错误率最低(37%),ChatGPT Search 67%,Gemini 76%(Suprmind 2026-04 数据)。关键实践:对重要结论,无论哪个平台生成,都要手动点开引用链接核实。