2026 Embedding 模型全景对比:从 MTEB 榜单到 RAG 选型决策
TL;DR
- What this is: A deep comparison of text/multimodal embedding models as of late 2026, based on MTEB English/Multilingual v2 and RTEB leaderboards (checked 27 Oct 2026), vendor pricing pages, and independent retrieval benchmarks.
- This is for: Engineers building RAG pipelines, agent memory systems, or semantic search — anyone who must pick an embedding model and commit to re-indexing costs.
- We chose: No single winner. The right pick is a constraint filter (license, data residency, language, modality) followed by a 100–200 query eval on your own corpus. Qwen3-Embedding is the strongest default open model; voyage-4-large is the strongest hosted API; Gemini Embedding 2 wins cross-lingual + multimodal; Cohere Embed 5 wins long documents.
一、为什么 Embedding 模型值得单独写一篇
Embedding 模型是 RAG 系统的隐形地基。它在流水线里跑两次:一次离线索引时嵌入每一个 chunk,一次每次请求时嵌入用户问题并找最近邻。那些 chunk 就是语言模型唯一能读到的上下文,所以 embedding 模型在生成开始之前就设定了回答质量的上限。
选错 embedding 模型的代价是终身的:向量来自不同模型不可比,换模型 = 全量重嵌入。一篇 2026 年的对比文章里反复出现的数字是——重新嵌入 1000 万个 chunk 大约花费 $520(按 2026 年 9 月价格),所以这不是”明天改一行配置”的事,而是”索引建好了就别轻易动”的事。
另一个动机:公开榜单往往误导。MTEB 总分是 7 种任务的平均(检索、语义相似、分类、聚类、成对分类、重排、摘要),只有一种和搜索有关。一个模型可能因为分类强就爬上总榜,检索反而平庸。所以这篇文章的核心方法论是:看检索列,不看总分。
二、先搞懂榜单:MTEB vs RTEB
| 榜单 | 覆盖 | 对 RAG 的意义 |
|---|---|---|
| MTEB English v2 | 41 个任务,349 个模型 | 英语单语种检索/语义基线 |
| MTEB Multilingual v2 | 131 个任务,483 个模型 | 跨语种检索,250+ 语言平均 |
| RTEB(beta) | 30 个任务,混合公开/私有数据 | 纯检索榜,部分数据私有防训练泄漏 |
三个关键陷阱(2026-10-27 快照真实存在):
- 训练重叠:MTEB 榜首附近的几个开源模型,零样本占比只有 48%——它们训练时见过约一半的测试任务。
- 覆盖缺口:2026 年最常用的托管模型(Voyage 4 族、Gemini Embedding 2、Cohere Embed 5)都没有完整 MTEB v2 分数,按总分排序的表会直接把它们丢掉。
- 任务混合:MTEB 总分混合聚类/分类与检索,模型可以在总榜爬升而检索没变好。
结论:用 MTEB 的 retrieval 列,或者直接用 RTEB(只测检索,且部分数据私有、无法训练)。自报分数(厂商自己的 model card)比榜单分数乐观,优先相信榜单独立运行的结果。
三、核心对比表(2026-10-27 快照)
以下是 15 个值得关注的模型,数据来自 MTEB/RTEB 榜单 API、模型 card、厂商定价页(同日核对)。
开源权重模型(自托管)
| 模型 | 许可证 | 参数量 | 维度(可截断) | 最大 token | MTEB En v2 | MTEB Multi v2 | RTEB |
|---|---|---|---|---|---|---|---|
| Qwen3-Embedding-8B | Apache 2.0 | 8B | 4096(32~4096) | 32K | #5 | #4 | #15 |
| Qwen3-Embedding-4B | Apache 2.0 | 4B | 2560(MRL) | 32K | #7 | #6 | n/r |
| Qwen3-Embedding-0.6B | Apache 2.0 | 0.6B | 1024(32~1024) | 32K | #27 | #20 | n/r |
| harrier-oss-v1-27b | MIT | 27B | 5376 | 32,768 | n/r | #1 | n/r |
| harrier-oss-v1-0.6b | MIT | 0.6B | 1024 | 32,768 | #22 | #10 | n/r |
| Nemotron-3-Embed-8B | OpenMDW-1.1 | 8B | 4096(可切) | 32,768 | n/r | n/r | #2 |
| Nemotron-3.5-Embed-8B | OpenMDW-1.1 | 8.38B | 4096(可截断) | 32,768 | n/r | n/r | n/r(文本嵌入与 3-Embed 相同) |
| Octen-Embedding-8B | Apache 2.0 | 8B | 4096 | 32,768 | n/r | #7 | #3 |
| EmbeddingGemma 2 | Apache 2.0* | 270M 文本 | 768(512/256/128) | 8,192 | #59 | #40 | n/r |
| BGE-M3 | MIT | 568M | 1024 密集 + 稀疏 + 多向量 | 8,192 | n/r | n/r | n/r |
| voyage-4-nano | Apache 2.0 | ~340M | 1024(256/512/2048) | 32,000 | n/r | n/r | n/r |
| all-MiniLM-L6-v2 | Apache 2.0 | 23M | 384 | 256 | #150 | #152 | #85 |
* EmbeddingGemma 2 的 card 标 Apache 2.0,但要求遵守 Google 的 Gemma 禁止用途政策,且 MTEB 元数据仍标 Gemma 许可证。
托管 API 模型
| 模型 | 提供商 | 维度 | 最大 token | 模态 | 价格/1M tokens |
|---|---|---|---|---|---|
| voyage-4-large | Voyage AI | 1024(256/512/2048) | 32,000 | 文本 | $0.12 |
| voyage-4 | Voyage AI | 1024(256/512/2048) | 32,000 | 文本 | $0.06 |
| voyage-4-lite | Voyage AI | 1024(256/512/2048) | 32,000 | 文本 | $0.02 |
| gemini-embedding-2 | 3072(128~3072) | 8,192 | 文本/图像/视频/音频/PDF | $0.20($0.10 批处理) | |
| gemini-embedding-001 | 3072(128~3072) | 2,048 | 文本 | 未列价(榜单 #9/#5/#13) | |
| Cohere Embed 5 Pro | Cohere | 2048(1536~256) | 128K | 文本+图像+混合 PDF | $0.12 |
| Cohere Embed 5 Fast | Cohere | 2048(1536~256) | 128K | 文本+图像 | $0.08 |
| text-embedding-3-large | OpenAI | 3072(可缩短) | 8,192 | 文本 | $0.13 |
| text-embedding-3-small | OpenAI | 1536(可缩短) | 8,192 | 文本 | $0.02 |
关键解读
- Qwen3-Embedding-8B 是开源默认:Apache 2.0、32K 上下文、每个尺寸都支持 MRL 截断、指令感知(查询侧写 task instruction)、还有配套的 Qwen3-Reranker(0.6B/4B/8B)。榜单标注它 95% 的 En v2 任务、99% 的 Multi v2 任务是零样本,分数不是靠训练测试集刷出来的。
- harrier-oss-v1-27b 是质量天花板:MIT 许可,MTEB Multi v2 #1(0.7427),检索列 0.7827 全场最高。但权重约 54GB(bf16),不是默认,是”质量上限”。
- Nemotron-3-Embed-8B 是检索榜王者:RTEB #2(仅次于一个 2048 维 + 进化提示词的 voyage-4-large 配置),OpenMDW-1.1 明确商用。Nemotron 3.5 版加了图像文档,且文本嵌入与 3-Embed 相同——文本用户无感升级,多模态用户保留文本质量。
- 领域检索:合同、申报、临床笔记 → 把 Nemotron-3-Embed 和 Octen-Embedding 放进候选列表。
- 许可证陷阱:jina-embeddings-v5-text-small 是 CC BY-NC 4.0(商用需联系 Jina);NV-Embed-v2 是 CC BY-NC 4.0;KaLM-Embedding-Gemma3-12B 是自定义社区许可。Multi v2 前五名里有两个需要法务先看,这是 Apache/MIT 选项最有力的现实论据。
四、托管 API:不想自托管时怎么选
首选:voyage-4-large($0.12/M)
纯检索榜上最强的托管模型:默认 1024 维排 RTEB #6,2048 维 + 进化提示词排 #1。32,000 token 上下文,是 OpenAI 的 4 倍。
Voyage 4 族的杀手锏是共享向量空间:voyage-4-large、voyage-4、voyage-4-lite、开源 voyage-4-nano 四个模型产生兼容向量。你可以用贵的大模型索引全量语料,用便宜的 lite($0.02)或自托管 nano 做查询,无需重索引。Voyage 称这种非对称配置在其测试的 8 个领域都提升了检索。二值输出还能把存储缩小 32 倍(同维度 float32 对比)。
价值之选:text-embedding-3-small($0.02/M)
最便宜的基线,与 voyage-4-lite 同价,但 RTEB #54 vs voyage-4-lite #22——同价下 Voyage 明显更强。适合先做基线,再测大模型是否值得升级。
多模态/全模态:gemini-embedding-2($0.20/M)
唯一把文本、图像、视频、音频、PDF 放进同一个向量空间的模型,100+ 语言,8,192 token。注意:它的向量与 gemini-embedding-001 不兼容,升级必须全量重嵌入。检索输入格式也变了(task: question answering | query: ...),不再是旧的 task_type 参数。
长文档/扫描件:Cohere Embed 5($0.12 Pro / $0.08 Fast)
唯一有 128K token 输入的托管模型,文本+图像+混合 PDF 共用一个空间,Matryoshka 从 2048 降到 256,float/int8/二值输出。Pro 和 Fast 共享空间(可索引用 Pro、查询用 Fast)。Qdrant 的独立测试(标准 nDCG@10,5 个公开 ViDoRe V3 语料,12,969 页图像,1,489 题)给 Embed 5 Pro 打了 65.8(单向量/页),落后 ColEmbed-3B-v2 的 67.5。尚无独立 MTEB/RTEB 分,厂商自报的数字先存疑。
OpenAI 生态:text-embedding-3-large($0.13/M)
MTEB 64.6,8,192 token,3072 维(可缩短)。被 Voyage/Gemini/Cohere 在检索上超越,但生态集成是它的护城河:LLM 调用、微调、assistant API 全在一个平台。MRL 截断到 1024 维存储省 3 倍、检索只降 ~2%。
五、开源模型:自托管的现实选择
默认推荐:Qwen3-Embedding
理由不是”榜首”,而是每个维度都均衡:
- 8B 版:MTEB En v2 0.7522(#5)、Multi v2 0.7058(#4),Multi 检索列 0.7088;95%/99% 任务零样本
- 32K 上下文(每个尺寸都有)
- MRL 截断从全宽到 32 维
- 指令感知:查询侧写
Instruct: Represent this document for retrieval\nQuery:通常提升 1-5% - 配套 Qwen3-Reranker(0.6B/4B/8B)
硬件估算法:bf16 约 2 字节/参数,8B 需 ~16GB GPU 显存(激活和批处理另算),4B ~8GB,0.6B ~1.2GB。CPU 服务请留在 10 亿参数以下并限制输入长度。从 0.6B 起步,只有自己的评测证明收益才升 4B/8B。
亚 10 亿参数的小模型(CPU/边缘/低延迟)
| 模型 | 参数量 | 维度 | 上下文 | 特点 |
|---|---|---|---|---|
| harrier-oss-v1-0.6b | 0.6B | 1024 | 32,768 | Multi v2 #10,比 Qwen3-0.6B 高 10 位 |
| Qwen3-Embedding-0.6B | 0.6B | 1024(MRL) | 32K | En v2 检索列更强(0.6183 vs 0.5845) |
| EmbeddingGemma 2 | 270M | 768 | 8,192 | Apache 2.0 + 音频/图像同一空间 |
| UltraBERT-Embed-150M | 151M | 768 | 32,768 | 最小 32K 上下文模型,纯英文 |
| granite-embedding-311m-multilingual-r2 | 311M | 768 | 32,768 | Apache 2.0,311M 有 32K 很罕见 |
| BGE-M3 | 568M | 1024 | 8,192 | MIT,密集+稀疏+多向量三合一 |
如果你的语料是混合的(含 ID、型号、错误码),混合检索是生产默认:向量索引找意图 + 关键词索引找字面匹配。BGE-M3 是唯一单模型同时产出密集、稀疏、多向量表示的——一个模型服务混合索引两侧,MIT 许可。
一个被低估的差距
还在用 all-MiniLM-L6-v2?它的 En v2 检索列只有 0.4292,Qwen3-Embedding-0.6B 是 0.6183。这不是小差距,是换模型级别的提升。
六、四个真实生产场景的独立评测(Milvus CCKM 基准)
MTEB 只测单语种文本检索。Milvus/Zilliz 做了一个 CCKM 基准(Cross-modal, Cross-lingual, Key information, MRL),专门测榜单漏掉的四件事。10 个模型,2025-2026 发布。
1. 跨模态检索(文本→图像,近重复干扰项)
| 模型 | R@1 | 模态间隙 |
|---|---|---|
| Qwen3-VL-2B | 0.945 | 0.25 |
| Gemini Embedding 2 | 0.928 | 0.73 |
| Voyage Multimodal 3.5 | 0.900 | 0.59 |
| Jina CLIP v2 | 0.873 | 0.87 |
| CLIP ViT-L-14(2021 基线) | 0.768 | 0.83 |
开源 Qwen3-VL-2B 打败所有闭源 API。模态间隙(文本/图像簇的距离)是关键:Qwen 的 0.25 约为 Gemini 0.73 的三分之一,意味着文本和图像向量在空间里更接近,跨模态匹配更容易。小间隙 = 可在同一 collection 存文本+图像直接搜;大间隙可能需要重排步骤补偿。
2. 跨语种检索(中文↔英文,166 对平行句 + 152 个硬负样本)
| 模型 | R@1 | Easy | Medium | Hard(成语) |
|---|---|---|---|---|
| Gemini Embedding 2 | 0.997 | 1.000 | 1.000 | 1.000 |
| Qwen3-VL-2B | 0.988 | 1.000 | 1.000 | 0.969 |
| Jina Embeddings v4 | 0.985 | 1.000 | 1.000 | 0.969 |
| Voyage Multimodal 3.5 | 0.982 | 1.000 | 1.000 | 0.938 |
| OpenAI 3-large | 0.967 | 1.000 | 1.000 | 0.906 |
| Cohere Embed v4 | 0.955 | 1.000 | 0.980 | 0.875 |
| BGE-M3 | 0.940 | 1.000 | 0.960 | 0.844 |
| nomic-embed-text | 0.154 | 0.300 | 0.120 | 0.031 |
| mxbai-embed-large | 0.120 | 0.220 | 0.080 | 0.031 |
Gemini 2 是唯一在 Hard 层(成语”画蛇添足”→”gilding the lily”)拿满分的模型——真正的跨语言语义理解,不是模式匹配。英文专注的小模型(nomic/mxbai)在跨语种上几乎归零。
3. 关键信息检索(4K~32K 文档中找一根针)
| 模型 | 1K | 4K | 8K | 16K | 32K | 衰减 |
|---|---|---|---|---|---|---|
| Gemini Embedding 2 | 1.000 | 1.000 | 1.000 | 1.000 | 1.000 | 0% |
| OpenAI 3-large | 1.000 | 1.000 | 1.000 | — | — | 0% |
| Jina v4 | 1.000 | 1.000 | 1.000 | — | — | 0% |
| Cohere v4 | 1.000 | 1.000 | 1.000 | — | — | 0% |
| BGE-M3 | 1.000 | 1.000 | 0.920 | — | — | 8% |
| mxbai | 0.980 | 0.600 | 0.400 | — | — | 58% |
| nomic | 1.000 | 0.460 | 0.440 | — | — | 56% |
前 7 名在各自上下文窗口内满分;BGE-M3 在 8K 开始滑(0.920);轻量模型(mxbai/nomic)在 4K 字符(约 1000 token)就掉到 0.4-0.6——mxbai 是因为 512 token 窗口直接截断。
4. MRL 维度压缩(3072 → 256 维,质量损失)
| 模型 | 256 维质量变化 |
|---|---|
| Voyage Multimodal 3.5 | +0.6% |
| Jina Embeddings v4 | +0.5% |
| Gemini Embedding 2 | -0.6% |
从 3072 到 256 维是 12 倍存储减少(1 亿向量 float32 约 1.14 TB → 95 GB)。Voyage MM-3.5 和 Jina v4 截断到 256 维损失不到 1%,Gemini 只损失 0.6%——这些模型可以放心压缩。有的模型截断后显著退化,所以截断前先在自己的评测集上对比。
七、长上下文 ≠ 不分块(反直觉但重要)
32K token 窗口让你能把整篇文档嵌成一个向量。但 Qdrant 用 UltraBERT-Embed-150M 测了整篇 vs 512-token 分块(nDCG@10,LongEmbed 基准):
| 任务 | 整篇向量 | 512-token 分块 |
|---|---|---|
| SummScreenFD(单主题文档) | 0.974 | 0.954 |
| QMSum(多主题会议) | 0.536 | 0.712 |
| 2WikiMultihopQA(多跳) | 0.929 | 0.991 |
| MLDR(20 万篇文章) | 0.509 | 0.683 |
| needle 32K | recall@1 30% | recall@1 56% |
结论:整篇向量只赢在”文档就讲一件事”的场景。多主题、多跳、需要精确定位的文档,分块显著更好。32K 窗口是长章节和表格的余量,不是停止分块的理由。此外嵌入整篇会议记录耗时约为分块的 3 倍(NVIDIA L4 上)。
八、语义搜索 vs 向量搜索(50,000 文档实测)
Maximem 自己的 50,000 文档 / 5,000 查询研究,揭示了 embedding 模型在检索里的真实权重:
- 向量搜索整体领先关键词:MRR@10 0.6320 vs 0.5325
- 但去掉自然语言→代码数据集后,排名反转:精确匹配关键词 0.5931 vs 向量 0.5614
- 科学考题上关键词碾压向量:0.8145 vs 0.6142——因为”线粒体”这个词本身就是答案,不是概念的近似
嵌入模型无法修复的失败模式(Galileo/Splunk 文档也确认):
- “2024 Q3 营收”会检索出所有季度的营收段落,因为年份在向量里权重极低
- “不含外部依赖的 Python 示例”会检索出含依赖的(排除类查询失效)
- 多跳 HotpotQA 失败模式:向量找到第一个实体文档,错过第二个的桥接文档——桥接文档不像查询
结论:混合检索是生产默认(关键词找 ID/名称/罕见词 + 向量找释义/意图 + 合并)。更好的 embedding 缩小差距,但不消除这类查询。
延迟:embedding 税
Meilisearch 在 AWS London 实测:本地 all-MiniLM-L6-v2 约 10ms/查询,本地 bge-large-en-v1.5 约 60ms,网络 OpenAI text-embedding-3-small 约 460ms、3-large 约 750ms。搜索即打字(search-as-you-type)场景基本只有本地亚 10 亿模型能胜任。
索引成本同样可观:同一台机器建 50,000 文档关键词索引 2.11 秒,嵌入+索引 161.6 秒——差 76 倍。每次换 embedding 模型都要重付这笔税。
九、RAG 选型七步法(可直接执行)
选 embedding = 约束过滤 + 自己的数据上做实验。榜单是候选名单,你的标注查询是决策。
- 先写硬约束:许可证(能否商用)、数据能否出内网、必须支持的语言、每查询延迟预算、月支出上限。这些淘汰的候选比任何榜单都多。
- 候选 4 个:取 MTEB En/Multi v2 检索列顶部 + RTEB 顶部,按约束过滤,含 1 个小模型做基线。今天英语商业产品的合理候选:Qwen3-Embedding-4B、harrier-oss-v1-0.6b、Nemotron-3-Embed-8B + 一个托管模型(voyage-4 或 text-embedding-3-small)。
- 建 100~200 条标注评测集:来自你真实的问题,每条带答案 chunk 的 ID。包含精确标识符、释义、答案在表格里的、以及几条无答案的。
- 评检索而非答案:用 nDCG@10(正确 chunk 是否靠前)、Recall@10(是否出现)、MRR@10(第一个正确命中多高)。答案质量取决于生成器和提示词,单独测。
- 同时测延迟、存储、价格:100 万向量 @1024 维 float32 约 4.1GB,int8 约 1GB,二值约 128MB;@4096 维 float32 约 16.4GB。嵌入 10 亿 token:$20(text-embedding-3-small / voyage-4-lite)、$60(voyage-4)、$80(Embed 5 Fast)、$120(voyage-4-large / Embed 5 Pro)、$130(text-embedding-3-large)、$200(gemini-embedding-2)。选评测能容忍的最小模型 + 最小维度。
- 上下文长度匹配分块,而非反向:32K 窗口 ≠ 嵌 32K chunk;一个向量模糊整个文档的所有事实。大多数 RAG 流水线在段落/章节级分块检索最佳。
- 为下一个模型做准备:原始文本和 chunk ID 与向量分开存储,这样重嵌入是批处理任务而非迁移。
最小评测脚本(Sentence Transformers):
1 | from sentence_transformers import SentenceTransformer |
何时微调 / 用领域模型
语料充满通用模型少见的词汇(药名、法规引用、内部产品码)时,先找领域模型、再微调通用模型。领域差异真实存在:2026-09 AIMultiple 的 11 个开源模型基准(金融/法律/技术支持/医疗各 50 题,nDCG@10 单次运行)里,BGE Large EN v1.5 领跑金融子集、总分排第四。微调通常对领域内查询提升 10-30%,前提是 500-1000 条标注的查询-文档对。
十、切换成本与数据主权
换模型 = 重嵌入一切,因为不同模型的向量不可比。Google 直接说明:gemini-embedding-001 和 gemini-embedding-2 产生不兼容空间,升级必须重嵌所有现有数据。
三个厂商现在卖”同族共享空间”:
- Voyage:voyage-4 全系列向量兼容(含开源 nano)
- Cohere:Embed 5 Pro 和 Fast 共享空间(一档查询另一档的索引有少量损失)
- NVIDIA:Nemotron 3.5 Embed-8B 与 Nemotron-3-Embed-8B 产生相同文本嵌入,加图像文档不强制文本重嵌
数据主权另一半:托管 API 会收到你的每个 chunk 和每次查询。Google 定价页写免费层输入用于改进产品、付费层不用于训练。自托管把文本留在内网,代价是 GPU 服务、升级、on-call——这个权衡应该被工程经理显式定价,因为每次模型升级都要重来。
十一、2026 年的新变化(9-10 月五连发)
9 月 26 日以来五个值得知道的新模型,各自改变了什么:
| 模型 | 发布 | 改变什么 |
|---|---|---|
| EmbeddingGemma 2 | 10/6 | 许可证从 Gemma 条款移到 Apache 2.0,输入 2K→8K,768 维覆盖文本/代码/图像/视频/音频,270M 文本骨干 |
| Cohere Embed 5 | 9/30 | Pro/Fast 两档共享空间,128K 输入,图文融合,Matryoshka 2048→256,float/int8/二值 |
| Nemotron 3.5 Embed | 10/20 | 给 Nemotron-3 加图像文档,文本嵌入相同(文本用户无感),1B 版同步 |
| pplx-embed-v2 | 10/13 | Perplexity MIT 许可的 late-interaction 模型,每 token 一个 128 维向量,直接嵌页面图像免 OCR |
| UltraBERT-Embed-150M | 10/10 | 151M、Apache 2.0、纯英文,32,768 token 单向量 |
pplx-embed-v2 的存储陷阱:每页图像约变成 1,700 个向量、float32 约 856KB/页;1-bit 量化砍到 40KB 但保留 96.5% 质量(重排前)。页面图像得分高,但先算索引价格再选。
EmbeddingGemma 2 的落差:card 自报 68.46(En v2)比 v1 高,但榜单独立运行 0.6753(#59)低于 v1 的 0.6967(#34)。自报和独立运行都真实,差距来自谁跑的、怎么跑的。另外 card 警告:float16 下返回 NaN 或静默退化嵌入,用 bfloat16 或 float32。
榜单本身也在动:harrier-oss-v1-0.6b 从无分到 En v2 #22(比 Qwen3-0.6B 高 5 位);jina-embeddings-v5-text-small 从 9/26 的 #15 变成只有 38/41 任务无完整分——排名变化可能是覆盖率变化,模型没变。
十二、配图说明
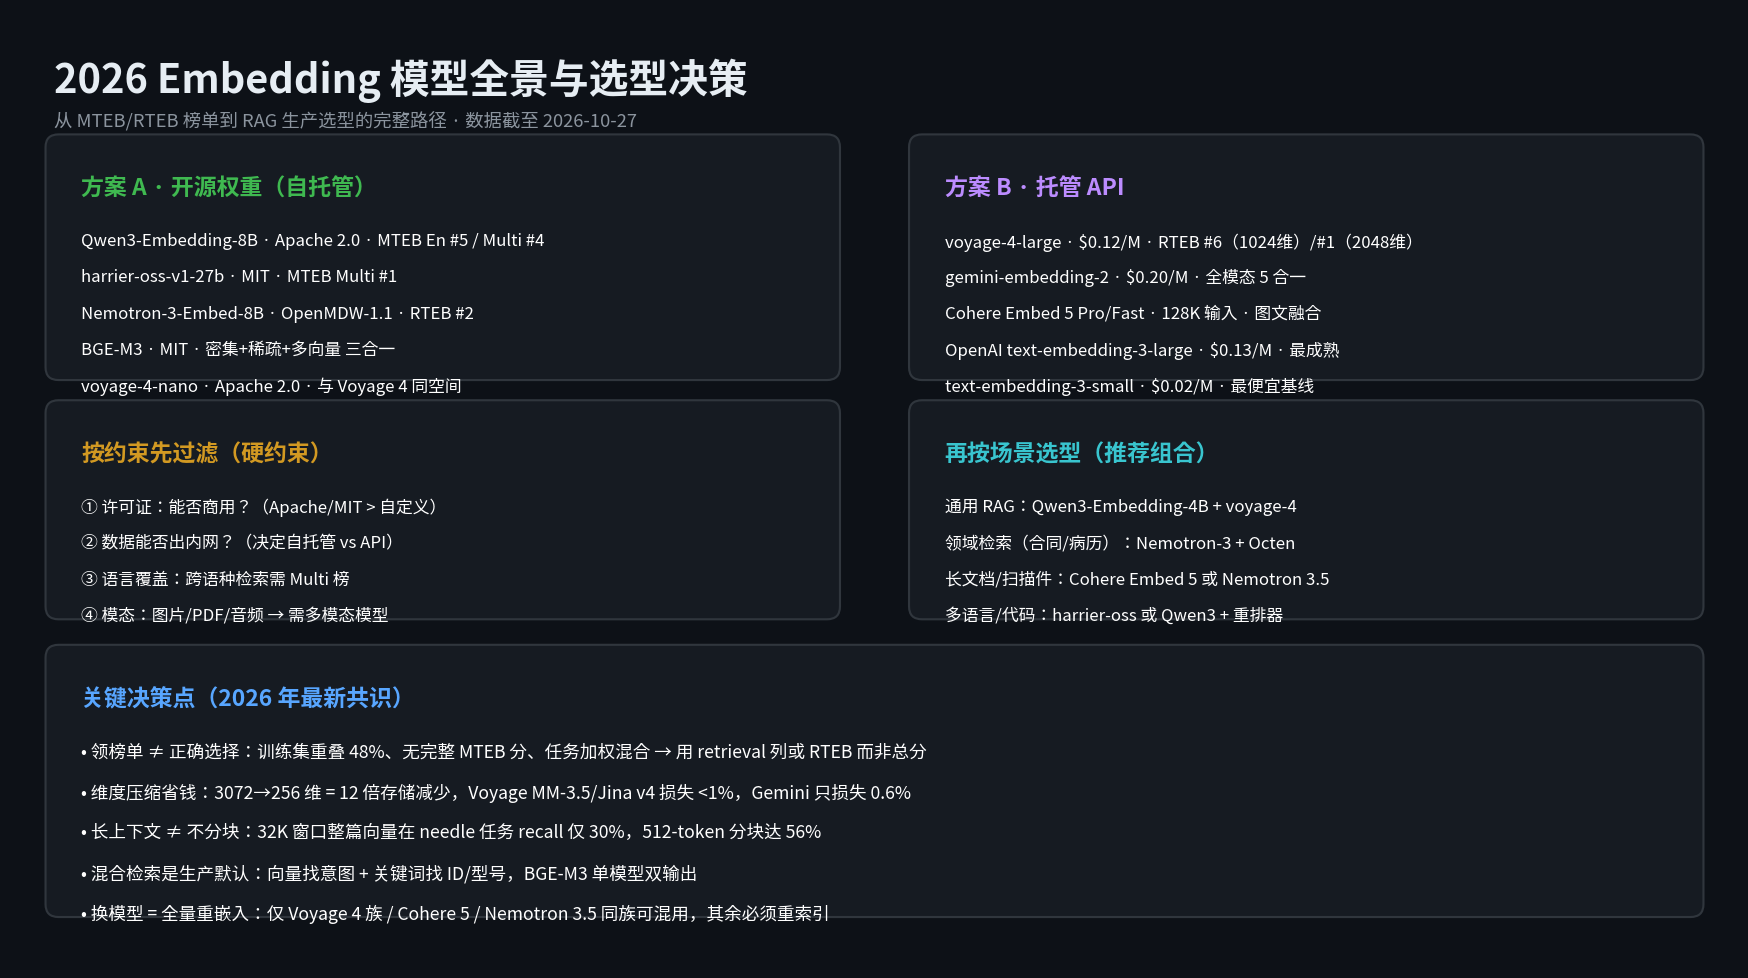
文章封面图(embedding-models-overview-2026.png)为 Matplotlib 手绘架构图,深色背景蓝紫配色,概括了本文的选型决策路径:开源 vs 托管两条路线 → 硬约束过滤 → 场景推荐组合 → 五个关键决策点。
❓ 常见问题(FAQ)
Q: 2026 年最好的 Embedding 模型是哪个?
没有单一答案。按用途:通用 RAG 首选开源 Qwen3-Embedding-8B(Apache 2.0,MTEB Multi #4,95% 零样本);托管 API 首选 voyage-4-large($0.12/M,RTEB 2048 维 #1);跨语种+多模态 Gemini Embedding 2(跨语种 R@1 0.997,唯一 Hard 层满分);长文档 Cohere Embed 5(128K 输入)。正确做法是约束过滤后在自己的 100-200 条查询上实测,而非看总分。
Q: 开源模型能用于生产 RAG 吗?
能。截至 2026-10-27,MTEB Multi v2 榜首是微软 MIT 许可的 harrier-oss-v1-27b,开源 Qwen3-Embedding-8B 排 #4 紧追 gemini-embedding-001。开闭源之争没有操作意义,重要的是谁托管、如何版本化、许可证是否允许商用。
Q: 可以用不同模型做查询和文档吗?
一般不能。每个模型有独立向量空间,查询向量与另一模型的文档向量不可比。例外是设计为共享空间的家族:Voyage 4 全系列、Cohere Embed 5 Pro/Fast、NVIDIA Nemotron 3.5/3-Embed。同一模型的查询/文档前缀不同是可以的,且往往必须。
Q: 维度大小影响 RAG 吗?
主要影响成本。存储和搜索成本随维度线性增长,3072 维向量占用是 1024 维的 3 倍。MRL(Matryoshka)训练让前 N 维独立有效:3072→256 维省 12 倍存储,Voyage MM-3.5/Jina v4 损失 <1%。但在截断前先在评测集上对比截断尺寸 vs 全尺寸。
Q: 应该多久重新评估一次 embedding 模型?
MTEB 榜单每 3-4 个月显著变动,新模型通常比前代检索提升 3-5%。务实节奏:每 6 个月用当前前三名重跑你的检索评测。若新模型在你语料上超过当前模型 5% 以上,规划迁移;低于 5%,重嵌入成本很少回本。
Q: 需要微调 embedding 模型吗?
通用语料一般不值得。专业领域值得,通常提升 10-30% 的领域内检索,前提是有 500-1000 条你真实语料的查询-文档对。没有就先建评测集,用强通用模型起步。